Une hallucination d’IA, c’est quoi ?
Une hallucination, c’est quand une intelligence artificielle te répond quelque chose de faux en te le présentant exactement comme si c’était vrai. Pas une erreur qu’elle signale, pas un « je ne sais pas ». Une réponse nette, bien tournée, sûre d’elle. Et inventée.
Le mot est trompeur, d’ailleurs. Il laisse entendre que la machine « voit » quelque chose qui n’existe pas, comme un humain sous fièvre. La réalité est plus prosaïque : le modèle produit du texte plausible, et il se trouve que ce texte ne correspond à rien de réel. Il n’a pas menti. Il n’a pas non plus dit la vérité. Il a fait la seule chose qu’il sait faire, et c’est là que tout se joue.
Pourquoi l’IA hallucine ?
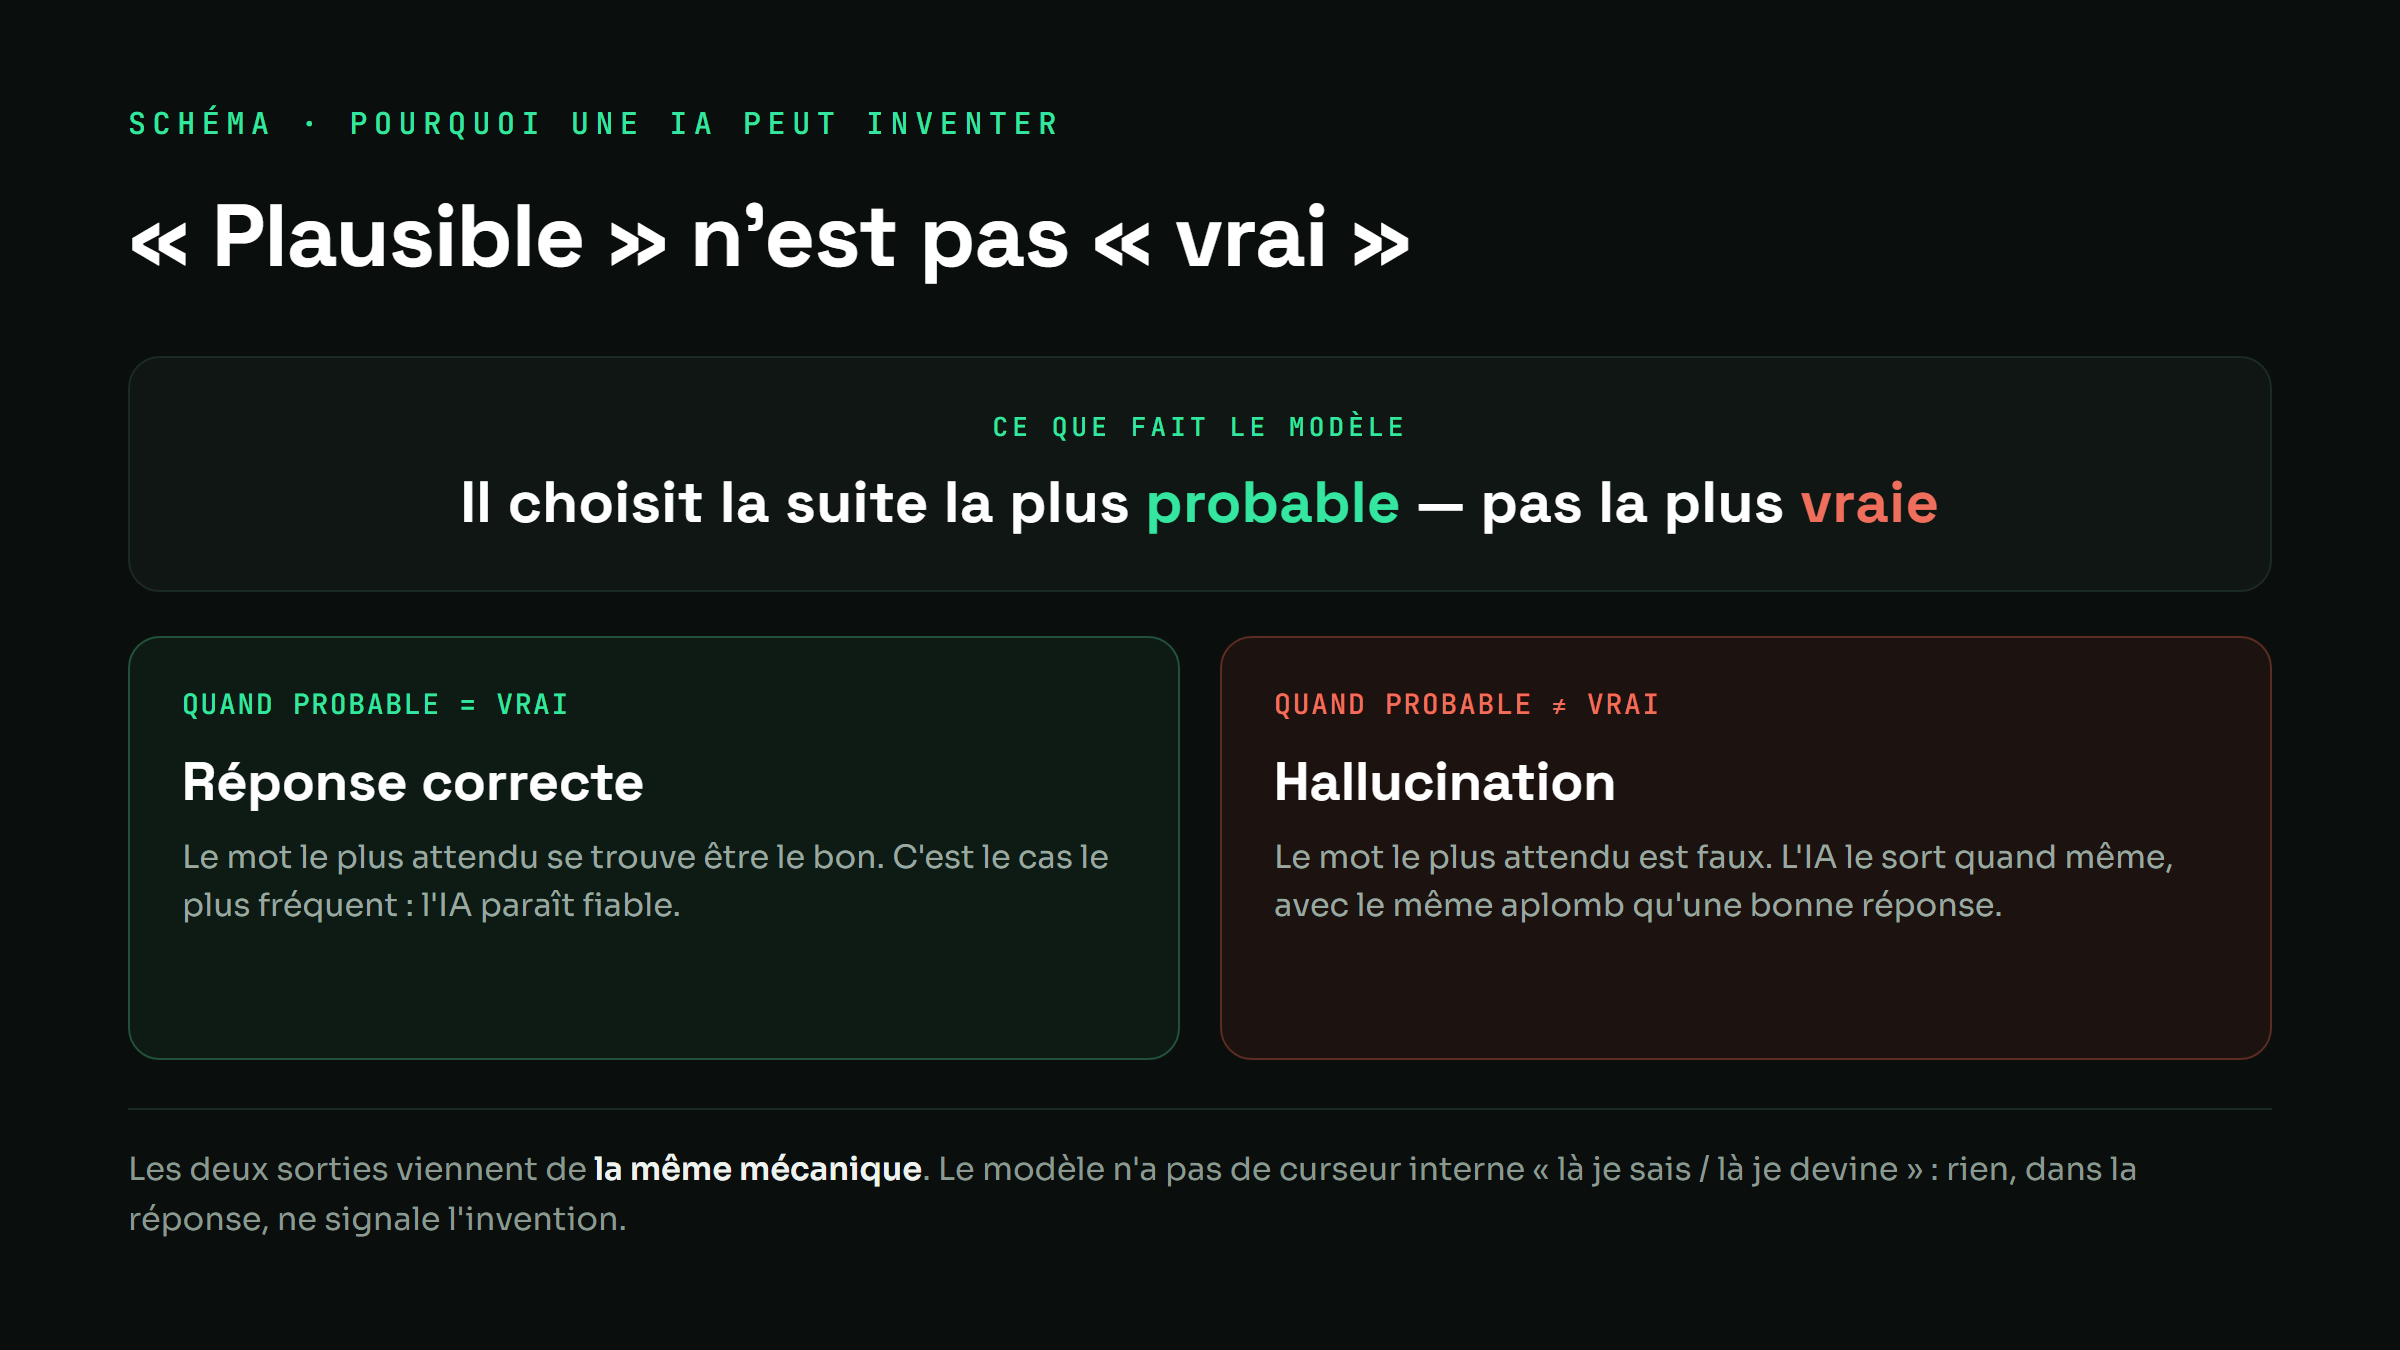
Pour comprendre, il faut savoir ce qu’un modèle de langage fait vraiment quand il te répond. Un grand modèle de langage (LLM) ne consulte pas une base de faits avant de parler. Il prédit, mot après mot (plus précisément token après token), la suite la plus probable, compte tenu de tout ce qu’il a lu à l’entraînement.
Autrement dit : il optimise la vraisemblance, pas l’exactitude. Ces deux choses coïncident souvent, heureusement. Mais quand elles divergent (une question pointue, un nom propre rare, une référence qu’il n’a jamais bien vue), le modèle ne s’arrête pas pour dire qu’il ignore. Il comble. Il génère la réponse qui ressemble le plus à une bonne réponse. Et une citation juridique inventée ressemble à s’y méprendre à une vraie citation juridique.
C’est pour ça qu’une hallucination est si convaincante : elle est fabriquée par la même mécanique qui produit les réponses correctes. Il n’y a pas, à l’intérieur, un signal « attention, là je devine ». Un prompt flou aggrave le phénomène, un prompt précis le réduit, mais aucun ne le supprime.
Trois hallucinations qui ont coûté cher
Le plus parlant reste les cas réels. En 2023, un avocat new-yorkais a remis au tribunal un mémoire truffé de jurisprudences… qui n’existaient pas. ChatGPT les avait inventées de toutes pièces, avec noms d’affaires, numéros et citations internes. Le juge Castel a sanctionné les avocats de 5 000 dollars pour ces fausses références (affaire Mata c. Avianca, juin 2023). L’outil n’avait pas bugué. Il avait fait exactement ce qu’on vient de décrire.
Un an plus tard, le chatbot d’Air Canada a expliqué à un client qu’il pouvait demander un tarif deuil rétroactivement. C’était faux : cette politique n’existait pas. Le tribunal de Colombie-Britannique a tranché en février 2024 : la compagnie était responsable des propos de son propre chatbot, et devait payer 812,02 dollars (décision Moffatt c. Air Canada, février 2024). Air Canada avait plaidé que le chatbot était « une entité distincte ». Le tribunal a trouvé l’argument, je cite le jugement, « remarquable ». Pas dans le bon sens.
Et puis il y a la version qui t’arrive à toi, sans procès : tu demandes des sources, l’IA te sort trois références précises, avec auteurs et dates, et deux d’entre elles sont introuvables parce qu’elles n’ont jamais été écrites. Ce n’est pas un cas extrême. C’est le comportement de base quand tu pousses le modèle hors de ce qu’il maîtrise.
À quelle fréquence l’IA hallucine-t-elle ?
Ici, il faut être précis, parce que les chiffres qui circulent mélangent tout. Le classement public de Vectara (2026) mesure une chose bien délimitée : quand on demande à un modèle de résumer un document qu’on lui fournit, combien de fois invente-t-il une information absente du document. Sur cette tâche, les meilleurs modèles tournent autour de 0,7 %, et beaucoup de modèles courants plafonnent plus haut, vers 3 %.
Ce que ce chiffre établit : sur une tâche cadrée, avec la source sous les yeux, les modèles récents se trompent peu. Ce qu’il n’établit pas, et c’est le piège, c’est un taux d’erreur général. « L’IA se trompe 3 % du temps » ne veut rien dire. Pose-lui une question sans lui fournir la source, sur un sujet de niche, et le taux n’a plus rien à voir avec un benchmark de résumé. La fréquence dépend entièrement de ce que tu demandes.
Comment repérer et limiter une hallucination
Il n’existe pas d’interrupteur « zéro hallucination ». Mais tu peux réduire le risque et surtout apprendre à ne plus te faire avoir. Et si tu comptes sur un second modèle pour relire le premier, sache que ce juge a lui aussi ses biais, mesurés : un modèle qui note un modèle reste proche du hasard quand la réponse fausse est bien écrite.
- Vérifie toute donnée vérifiable. Un chiffre, une date, un nom, une citation, une référence juridique ou scientifique : si ça peut se contrôler, contrôle-le avant de t’en servir. C’est la seule parade fiable.
- Méfie-toi de l’aplomb. Une réponse assurée n’est pas une réponse juste. Le ton confiant est justement ce qui rend l’hallucination dangereuse : ne le prends jamais pour une preuve.
- Demande les sources, puis ouvre-les. Réclamer des références aide, mais seulement si tu vérifies qu’elles existent. Une source citée par l’IA et jamais ouverte ne vaut rien.
- Donne-lui la matière. Un modèle qui résume un document que tu lui fournis hallucine beaucoup moins qu’un modèle qui répond de mémoire. C’est tout le principe des systèmes qui branchent l’IA sur une base de documents vérifiés (le RAG) : lui donner à lire plutôt que le laisser deviner.
- Reformule. Un prompt précis, qui cadre le contexte et autorise explicitement le « je ne sais pas », laisse moins de place au comblement.
Retiens l’essentiel : l’hallucination n’est pas un défaut qu’on corrigera dans la prochaine version. C’est une conséquence directe de la façon dont ces modèles fonctionnent. Tant qu’une IA prédit du plausible au lieu de consulter du vrai, ta vigilance reste la dernière ligne de défense. Et ça vaut aussi pour ses explications : quand un modèle détaille son raisonnement, ce texte est lui aussi du plausible, pas le compte rendu de son calcul.