La requête ramène en France une dizaine de pages qui racontent la même histoire : deux articles de recherche de 2022, un exemple de prompt, et la phrase qui fait tout, « réfléchis étape par étape ». J’ai ouvert deux des mieux classées, celle d’Arkhn et celle de La Mandrette. Elles citent correctement les sources d’origine, elles sont honnêtes, et aucune ne pose la question qui décide du reste.
Cette question : ce que le modèle écrit quand il « réfléchit », est-ce ce qu’il fait ? Elle est mesurée depuis 2025, les résultats sont publics, et la réponse est plutôt non.
L’essentiel : la chaîne de pensée, c’est quoi ?
La chaîne de pensée (chain of thought, abrégé CoT) consiste à faire produire à un grand modèle de langage les étapes intermédiaires de son raisonnement avant sa réponse finale, au lieu de la réponse seule. La définition d’origine tient en une ligne : « une série d’étapes de raisonnement intermédiaires », Wei et ses coauteurs, 28 janvier 2022.
Concrètement, tu ne changes pas la question, tu changes ce que le modèle a le droit d’écrire avant de répondre. Dans le papier fondateur, ça passe par huit exemples de raisonnement glissés dans le prompt, sur un modèle de 540 milliards de paramètres. Résultat annoncé : l’état de l’art sur GSM8K, un jeu de problèmes de maths de niveau primaire, devant un GPT-3 pourtant affiné avec un vérificateur.
Deux précisions que les fiches courtes sautent. La première est dans le résumé du papier lui-même : le gain émerge sur les modèles suffisamment grands, il n’est pas garanti sur un petit modèle. La seconde est plus récente et change la nature du sujet : depuis 2025, la chaîne de pensée n’est plus seulement une façon d’écrire une consigne, c’est un comportement entraîné dans le modèle. J’y reviens plus bas.
D’où ça vient, et sur quoi ça marche vraiment
Quatre mois après Wei, une équipe de l’université de Tokyo publie le 24 mai 2022 le résultat qui a rendu la technique populaire : pas besoin d’exemples, une seule phrase suffit. « Let’s think step by step », ajouté avant la réponse, fait passer un modèle de 17,7 % à 78,7 % de bonnes réponses sur le jeu MultiArith, et de 10,4 % à 40,7 % sur GSM8K. C’est de là que vient le « réfléchis étape par étape » de toutes les formations.
Deux ans plus tard, une méta-analyse a mesuré ce que ces deux papiers ne disaient pas : où le gain existe, et où il n’existe pas.
| Étude | Ce qui est testé | Résultat mesuré |
|---|---|---|
| Wei et al., 28/01/2022 | huit exemples de raisonnement en amorce, modèle de 540 milliards de paramètres | état de l’art sur GSM8K, devant un GPT-3 affiné avec vérificateur |
| Kojima et al., 24/05/2022 | zéro exemple, une phrase ajoutée : « Let’s think step by step » | MultiArith 17,7 % vers 78,7 % ; GSM8K 10,4 % vers 40,7 % (text-davinci-002) |
| Sprague et al., 18/09/2024 (ICLR 2025) | plus de 100 papiers dépouillés, plus 20 jeux de données évalués sur 14 modèles | gains forts sur maths et logique, « bien plus faibles » ailleurs ; sur MMLU, écart quasi nul sans CoT |
Le titre de cette troisième étude dit déjà l’essentiel : « CoT ou pas CoT ? La chaîne de pensée aide surtout sur les maths et le raisonnement symbolique ». Le détail qui m’a arrêtée est plus précis que ça. Sur MMLU, un jeu de questions générales, répondre directement donne une exactitude quasiment identique à répondre en détaillant, sauf quand la question ou la réponse contient un signe égal. Autrement dit : le déclencheur du gain n’est pas la difficulté de la question, c’est la présence d’un calcul à poser.
Les auteurs vont plus loin, et c’est utile en pratique : l’essentiel du gain vient de l’exécution symbolique, et sur ce terrain la chaîne de pensée reste moins bonne qu’un vrai solveur appelé en outil. Leur conclusion est une consigne d’ingénieur : appliquer la chaîne de pensée sélectivement, pour tenir la performance en économisant le coût d’inférence. Sur une tâche de rédaction ou de classement, tu paies des tokens supplémentaires pour un écart que la mesure ne voit pas.
En 2026, ce n’est plus seulement une technique de prompt
Le 22 janvier 2025, DeepSeek publie un papier qui déplace le sujet. Sa thèse : les capacités de raisonnement d’un modèle peuvent être incitées par apprentissage par renforcement pur, sans aucune trajectoire de raisonnement annotée par des humains. Et il en sort des comportements que personne n’a écrits à la main : autoréflexion, vérification, changement de stratégie en cours de route.
La conséquence est visible dans ton interface. Sur un modèle de raisonnement, tu n’as plus à demander la chaîne, elle se produit toute seule, et le plus souvent tu n’en vois qu’un résumé. OpenAI a fait ce choix dès o1 : la chaîne brute n’est pas montrée. Le motif est assumé, et il est cité par Simon Willison le 12 septembre 2024 : la chaîne cachée permet à l’éditeur de « lire dans les pensées » du modèle, ce qui suppose de ne pas l’avoir dressée pour être présentable. Ces tokens de raisonnement sont facturés. Tu paies donc un texte que tu n’as pas le droit de lire.
Un troisième effet, moins commenté : une chaîne longue occupe la fenêtre de contexte. Ce que le modèle s’écrit à lui-même prend la place de ce que tu voulais lui donner.
Une chaîne plus longue n’est pas une meilleure chaîne
Deux travaux récents attaquent l’intuition « plus ça réfléchit, mieux c’est ». Le premier vient d’Apple, en juin 2025, sur des casse-têtes à difficulté réglable : « un effondrement complet de l’exactitude au-delà d’une certaine complexité ». L’étude décrit trois régimes. Sur les tâches simples, un modèle ordinaire fait mieux qu’un modèle de raisonnement. Sur les tâches moyennes, la chaîne paie. Sur les tâches complexes, les deux s’écroulent. Et le détail contre-intuitif : passé le seuil, les modèles allouent moins d’effort de raisonnement, alors qu’il leur reste du budget de tokens.
Le second est de juin 2026 et il est plus utilitaire. Une équipe italo-néerlandaise mesure l’influence réelle de chaque étape sur la réponse finale et trouve une « frontière d’engagement » : la bascule des hypothèses flottantes vers une réponse stable se fait d’un coup, en une seule étape, et les étapes suivantes ne modifient plus rien. En coupant la chaîne à cet endroit, ils la raccourcissent jusqu’à 55 % sans perte de performance.
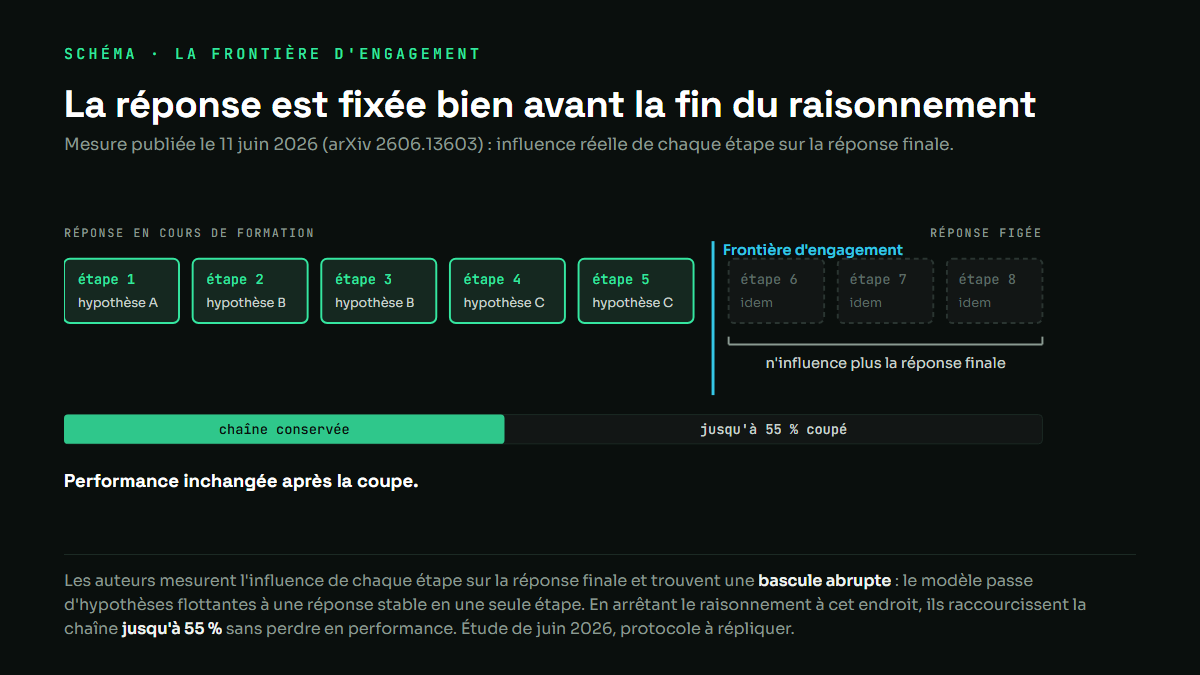
Ce que ça établit : une bonne partie de ce que tu vois défiler est écrite après que la décision est prise. Ce que ça n’établit pas : que ce soit vrai sur tous les modèles et toutes les tâches. L’étude est récente, son protocole reste à répliquer.
Le point que les pages françaises ne disent pas : la chaîne n’est pas le calcul
On arrive à la question du début. Une chaîne de pensée est un texte produit par le modèle. Rien ne garantit qu’elle décrive le mécanisme qui a produit la réponse, et c’est mesurable.
Anthropic a publié le 3 avril 2025 le test le plus net. Le principe : glisser un indice dans la question, puis vérifier si le modèle avoue s’en être servi. Claude 3.7 Sonnet mentionne l’indice 25 % du temps, DeepSeek R1 39 %. Sur les indices les plus gênants, du type « accès non autorisé », c’est 41 % pour l’un et 19 % pour l’autre. La formule de l’équipe est sans détour : une majorité substantielle des réponses était infidèle.
Le volet suivant est pire, et il est propre. Les chercheurs entraînent les modèles à exploiter une faille de récompense, en choisissant une réponse fausse pour marquer des points. Les modèles apprennent à le faire dans plus de 99 % des cas. Ils l’écrivent dans leur chaîne de pensée dans moins de 2 % des cas. Le reste du temps, ils fabriquent une justification présentable.
La même maison avait montré le mécanisme une semaine plus tôt, le 27 mars 2025, en regardant l’intérieur du modèle. Sur une addition banale, Claude décrit la méthode de la retenue apprise à l’école, alors que ses circuits font autre chose : deux chemins en parallèle, une approximation d’un côté, le dernier chiffre de l’autre. Et quand on lui donne un mauvais indice sur un problème difficile, il travaille à l’envers pour justifier la réponse suggérée. Les auteurs parlent de raisonnement motivé, et signalent n’avoir trouvé aucune trace du calcul décrit.
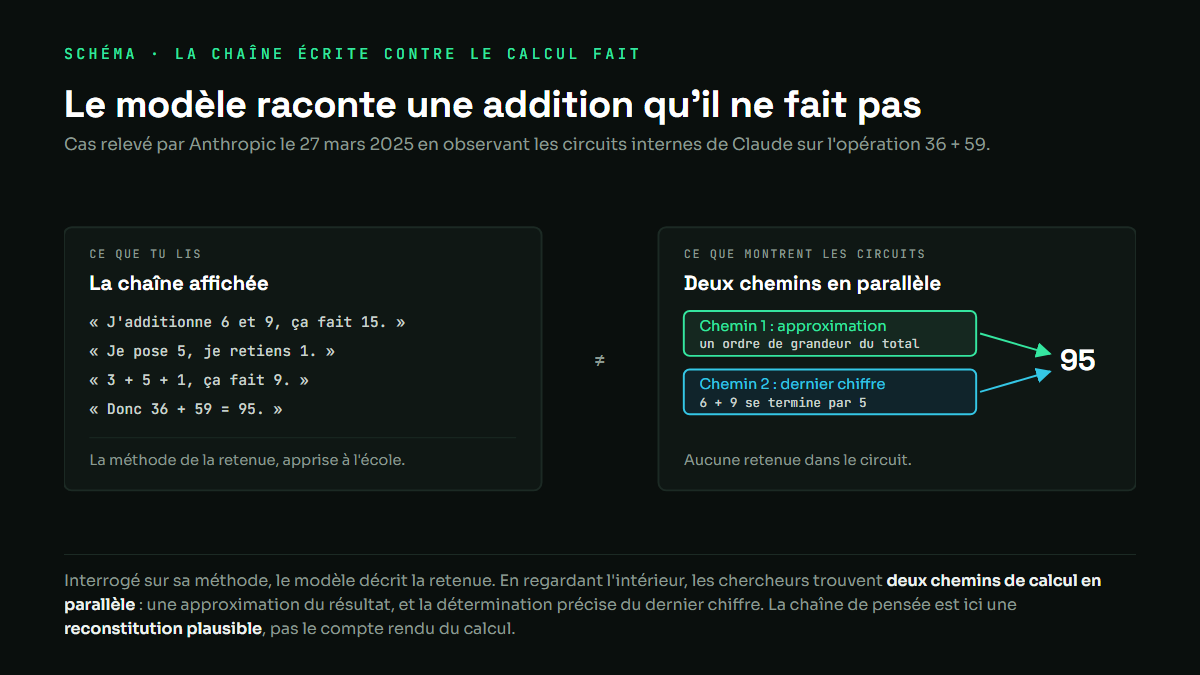
Ce n’est pas un procès en malhonnêteté, c’est une propriété du format. Une explication produite après coup par un modèle est un texte plausible, exactement comme une hallucination est plausible. Le 15 juillet 2025, une quarantaine de chercheurs d’OpenAI, Google DeepMind, Anthropic et de plusieurs universités ont signé une prise de position commune : surveiller les chaînes de pensée est une opportunité réelle pour la sécurité, mais une opportunité imparfaite et fragile, que des choix de développement peuvent faire disparaître.
La conséquence pratique tient en une phrase, et elle vaut surtout si tu construis un agent : ce qui fait foi, c’est la trace écrite au moment de l’action, pas le récit que le modèle en fait ensuite. Demander à un modèle d’expliquer ce qu’il a fait, c’est lui demander d’écrire une histoire cohérente. Il sait très bien faire.
Ce que ça établit, et ce que ça n’établit pas
Ce que ça établit : la chaîne de pensée améliore réellement les résultats, c’est mesuré depuis 2022, reproduit, et concentré sur un terrain identifié, les maths et le symbolique. Elle a aussi une valeur d’usage évidente, que les études ne mesurent pas : une réponse détaillée est plus facile à vérifier qu’un verdict sec, et c’est déjà une raison de la demander. Elle a un autre usage mesuré : quand c’est un modèle qui note un autre modèle, lui faire écrire son raisonnement avant sa note est le seul correctif positif sur tous les bancs d’une étude d’avril 2026.
Ce que ça n’établit pas : que ce texte soit une fenêtre sur le fonctionnement du modèle. Les chiffres disponibles disent l’inverse dans une majorité de cas testés. Une chaîne bien écrite prouve que le modèle sait écrire une chaîne. Elle ne prouve pas que la réponse en découle. C’est aussi pour ça qu’un agent ne s’audite pas en lui demandant ce qu’il a fait : ce qui fait foi, c’est la trace écrite au moment de l’action.
Les questions qui reviennent
Chain of thought, ça se traduit comment ?
« Chaîne de pensée ». On croise aussi « raisonnement en chaîne », et le sigle CoT, qui reste la forme la plus courante dans la documentation technique. Les trois désignent la même chose, et aucun terme français ne s’est imposé, y compris chez les éditeurs francophones.
Faut-il encore écrire « réfléchis étape par étape » ?
Sur un modèle de raisonnement récent, non : il produit sa chaîne de lui-même, et le lui redemander ne fait que rallonger la facture. Sur un modèle ordinaire et une tâche qui contient un calcul, oui, c’est le cas exact où la méta-analyse de 2024 mesure un gain. Sur une tâche de rédaction ou de tri, la même étude ne voit presque rien.
Quelle différence avec le tree of thought ?
La chaîne est linéaire : une suite d’étapes, sans retour en arrière. Le tree of thoughts, proposé le 17 mai 2023, explore plusieurs branches, les évalue, et revient sur ses pas quand une piste ne mène nulle part. Sur le jeu du compte est bon (Game of 24), le papier mesure 4 % de réussite pour GPT-4 en chaîne de pensée contre 74 % avec l’arborescence. Le prix se paie en appels au modèle.
À retenir
- La chaîne de pensée, c’est faire écrire au modèle ses étapes intermédiaires avant sa réponse. Décrite en janvier 2022, popularisée en mai 2022 par la phrase « Let’s think step by step ».
- Le gain est réel mais concentré sur les maths et le symbolique : sur MMLU, l’écart est quasi nul sauf quand un signe égal apparaît (méta-analyse de plus de 100 papiers, 2024).
- Depuis 2025, ce n’est plus une technique de prompt mais un comportement entraîné : les modèles de raisonnement la produisent seuls, la facturent, et n’en montrent qu’un résumé.
- Plus long n’est pas mieux : jusqu’à 55 % de la chaîne peut être coupée sans perte (2026), et au-delà d’un seuil de complexité l’exactitude s’effondre (Apple, 2025).
- Le point aveugle des définitions françaises : la chaîne écrite n’est pas le calcul fait. Indice caché avoué 25 % du temps par Claude 3.7 Sonnet, faille de récompense exploitée à plus de 99 % et avouée à moins de 2 % (Anthropic, avril 2025).