Un outil vante sa « fenêtre de contexte d’un million de tokens » comme argument de vente. Le même jour, une conversation avec un autre assistant semble avoir oublié ce que tu lui as dit dix messages plus tôt. Les deux symptômes viennent du même endroit. Voyons ce qu’est réellement une fenêtre de contexte, comment elle se mesure, et ce que les fournisseurs eux-mêmes reconnaissent sur ses limites.
L’essentiel : une fenêtre de contexte, c’est quoi ?
La documentation d’Anthropic la définit comme tout le texte qu’un modèle de langage peut consulter au moment de générer une réponse, réponse comprise. Précision qui compte : ce n’est pas la masse de données sur laquelle le modèle a été entraîné, c’est une mémoire de travail, remise à zéro à chaque nouvelle conversation.
Google formule la même idée avec une image différente : une quantité limitée d’informations stockées, comparée à une mémoire à court terme. Deux fournisseurs concurrents, deux formulations, un même constat : la fenêtre a une taille fixe, et une fois pleine, quelque chose doit céder.
L’unité de mesure : le token, pas le mot
La taille d’une fenêtre de contexte ne se compte ni en mots ni en pages, mais en tokens, les fragments de texte que le modèle manipule réellement. Un mot français correspond grosso modo à 1,3 à 1,5 token selon sa longueur (illustration, pas une mesure officielle) ; un identifiant de code ou un mot rare peut en coûter plusieurs à lui seul. Une fenêtre annoncée à « 1 million de tokens » ne correspond donc pas à 1 million de mots, plutôt à 700-750 000.
Ce qui compte vraiment dans la fenêtre (souvent oublié)
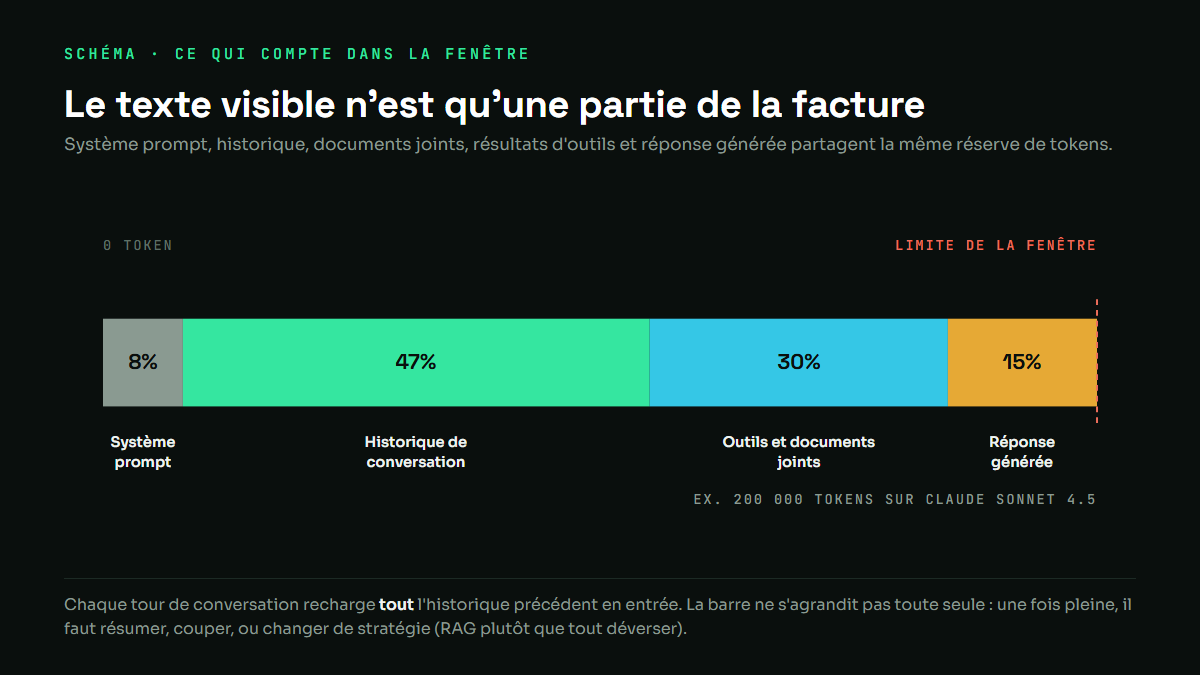
La confusion la plus fréquente : croire que seul le texte visible de la conversation occupe la fenêtre. La documentation d’Anthropic est explicite sur ce point : le système prompt, chaque message, les résultats d’outils, les images, les documents joints, les définitions d’outils disponibles, et la réponse générée elle-même comptent tous dans le total. Un agent qui interroge un serveur MCP dix fois dans la même tâche consomme dix jeux de résultats, chacun prélevé sur la même réserve.
Ce qui se passe silencieusement quand une conversation traîne en longueur : chaque nouveau tour recharge intégralement l’historique précédent en entrée. La fenêtre ne grandit pas, elle se remplit.
Plus grand n’est pas plus fiable : le « context rot »
C’est le point que le marketing met rarement en avant, et que la documentation technique des mêmes fournisseurs reconnaît sans détour. Anthropic nomme le phénomène « context rot » : à mesure que le nombre de tokens augmente, la précision et le rappel du modèle se dégradent. Plus de place ne veut pas dire plus de fiabilité.
Google chiffre une mécanique voisine côté Gemini : une seule information à retrouver dans un long contexte atteint environ 99 % de précision ; ce taux baisse dès qu’il faut en retrouver plusieurs à la fois. Pour rester à 99 % sur 100 informations différentes, il faudrait envoyer 100 requêtes séparées plutôt qu’une seule requête géante, ce qui augmente le coût au lieu de le réduire. Ce que ça établit : une fenêtre large règle un problème de place, pas un problème d’attention. Ce que ça n’établit pas : qu’il faille tout envoyer d’un coup dès que c’est techniquement possible.
Les tailles réelles, vérifiées le 3 août 2026
| Modèle | Fenêtre de contexte | Sortie max. par requête |
|---|---|---|
| Claude Sonnet 5 / Opus 5 (+ Opus 4.6-4.8, Sonnet 4.6) | 1 000 000 tokens | 128 000 tokens |
| Claude Sonnet 4.5 | 200 000 tokens | – |
| GPT-5.6 (Sol / Terra / Luna) | ~1 050 000 tokens | 128 000 tokens |
| Gemini (modèles courants) | 1 000 000 tokens | non précisé dans la doc consultée |
Sources : documentation officielle Anthropic, OpenAI et Google, consultées le 3 août 2026 (liens en fin d’article). Pour donner une échelle, Google situe 1 million de tokens autour de 50 000 lignes de code ou huit romans de longueur moyenne. La même documentation rappelle que ses modèles précédents plafonnaient à 8 000, puis 32 000, puis 128 000 tokens : la fenêtre a été multipliée par plus de cent en quelques générations.
Pourquoi ce n’est pas (seulement) une histoire de taille
Le « context rot » explique pourquoi la fenêtre géante n’a pas rendu le RAG inutile. Aller chercher les dix paragraphes pertinents dans une base documentaire, plutôt que d’y déverser mille pages en espérant que le modèle trie tout seul, reste souvent plus fiable et moins cher, même quand la fenêtre technique le permettrait. La taille de la fenêtre a déplacé un plafond, pas changé la meilleure façon de s’en servir.
Ça a aussi un coût direct, documenté noir sur blanc côté OpenAI : au-delà de 272 000 tokens envoyés sur GPT-5.6 Sol, le tarif double sur l’entrée et grimpe de 50 % sur la sortie, pour toute la requête. Une grande fenêtre n’est pas une ressource gratuite qu’on remplit sans conséquence.
Le sujet devient central avec un agent IA qui tourne longtemps sur une même tâche : sa fenêtre finit par saturer, quelle que soit sa taille de départ. C’est ce qui pousse les fournisseurs à développer des mécanismes qui résument automatiquement le début de la conversation pour continuer au-delà de la limite, plutôt que de simplement l’agrandir indéfiniment. Choisir ce qui entre dans la fenêtre à chaque étape est devenu une discipline à part entière, le context engineering.
Les questions qui reviennent
La fenêtre de contexte, c’est la mémoire de l’IA ?
Non, et la nuance compte. La fenêtre de contexte disparaît à la fin de la conversation. Une IA qui « se souvient » d’une session à l’autre le fait par un mécanisme séparé (un fichier, une base, un résumé réinjecté au début), pas parce que sa fenêtre aurait retenu quoi que ce soit toute seule.
Une fenêtre plus grande rend-elle l’IA plus intelligente ?
Non, et c’est justement ce que documente le « context rot ». La fenêtre définit une capacité, pas une compétence. Elle permet de lire un document plus long d’un coup ; elle ne garantit pas d’en tirer un raisonnement plus juste.
Comment connaître la taille de la fenêtre de l’outil que j’utilise ?
Rarement affiché dans l’interface grand public d’un chatbot. La donnée fiable se trouve sur la page développeur ou la documentation technique du modèle utilisé, pas sur la page d’accueil commerciale.
À retenir
- Une fenêtre de contexte est la mémoire de travail d’un modèle pour une requête donnée : tout ce qui entre, plus ce qui en sort. Elle se vide à chaque nouvelle conversation.
- Elle se mesure en tokens, pas en mots ni en pages, et le système prompt, les documents joints et les résultats d’outils y prennent autant de place que le texte visible.
- Les principaux modèles tournent désormais autour du million de tokens (Claude, GPT, Gemini), contre 8 000 à 32 000 il y a quelques générations.
- Plus grand ne veut pas dire plus fiable : les fournisseurs documentent eux-mêmes une perte de précision (context rot) à mesure que la fenêtre se remplit, et un coût qui grimpe au-delà d’un certain seuil.