Le terme est apparu à l’été 2025 et il a déjà ses formations, ses fiches de poste et ses pages « guide complet ». Le premier résultat français sur la requête n’aligne pas un seul chiffre. Les sources primaires, elles, en donnent beaucoup, et pas les plus flatteurs.
J’ai lu le billet d’Anthropic, celui de LangChain, celui des ingénieurs de Manus et l’étude de Chroma qui sert de socle à tout le monde. Regardons ce que le mot recouvre vraiment.
L’essentiel : le context engineering, c’est quoi ?
Anthropic pose d’abord le mot « contexte » : « l’ensemble des tokens inclus au moment où l’on échantillonne un grand modèle de langage », billet du 29 septembre 2025. Le context engineering est le travail qui consiste à choisir ces tokens : trouver, selon la même page, « le plus petit ensemble possible de tokens à fort signal qui maximise la probabilité du résultat voulu ».
La formule la plus reprise vient d’Andrej Karpathy, citée par LangChain le 2 juillet 2025 : « l’art délicat et la science de remplir la fenêtre de contexte avec exactement la bonne information pour l’étape suivante ». Deux mots comptent dans cette phrase. « Remplir », parce qu’on ne parle plus d’une consigne mais de tout ce que le modèle voit. « L’étape suivante », parce que le contenu change à chaque tour d’un agent.
La distinction avec le prompt est nette chez Anthropic : le prompt engineering désigne « les méthodes pour écrire et organiser les instructions », le context engineering « l’ensemble des stratégies pour constituer et maintenir le jeu optimal de tokens pendant l’inférence ». Ce n’est pas un nouveau nom pour la même chose. Le prompt est une ligne de la facture ; le context engineering, c’est la facture entière.
Pourquoi un mot de plus : le budget d’attention
Si les modèles lisaient parfaitement tout ce qu’on leur donne, la discipline n’existerait pas. Ils ne le font pas. Anthropic parle d’un « budget d’attention » qui s’épuise à mesure que le contexte grossit, et renvoie à l’étude qui l’a mesuré : « Context Rot », publiée par Chroma le 14 juillet 2025, sur 18 modèles dont GPT-4.1, Claude 4 et Gemini 2.5, testés sur 8 longueurs d’entrée et 11 positions de l’information à retrouver.
Le résultat tient en une phrase de l’étude : la performance « devient de plus en plus peu fiable à mesure que la longueur d’entrée augmente », y compris sur des tâches élémentaires. Un détail m’a arrêtée : les modèles s’en sortent mieux sur des textes mélangés au hasard que sur des textes logiquement structurés.
Ce que ça établit : la place disponible n’est pas la place utile. Ce que ça n’établit pas : un seuil universel au-delà duquel ça casse, il varie selon le modèle et la tâche.
J’ai déjà détaillé le mécanisme dans la fiche sur la fenêtre de contexte. Le context engineering en est la conséquence pratique : puisque tout ce qu’on ajoute dégrade un peu ce qui est déjà là, choisir devient un travail.
Les quatre gestes : écrire, sélectionner, compresser, isoler
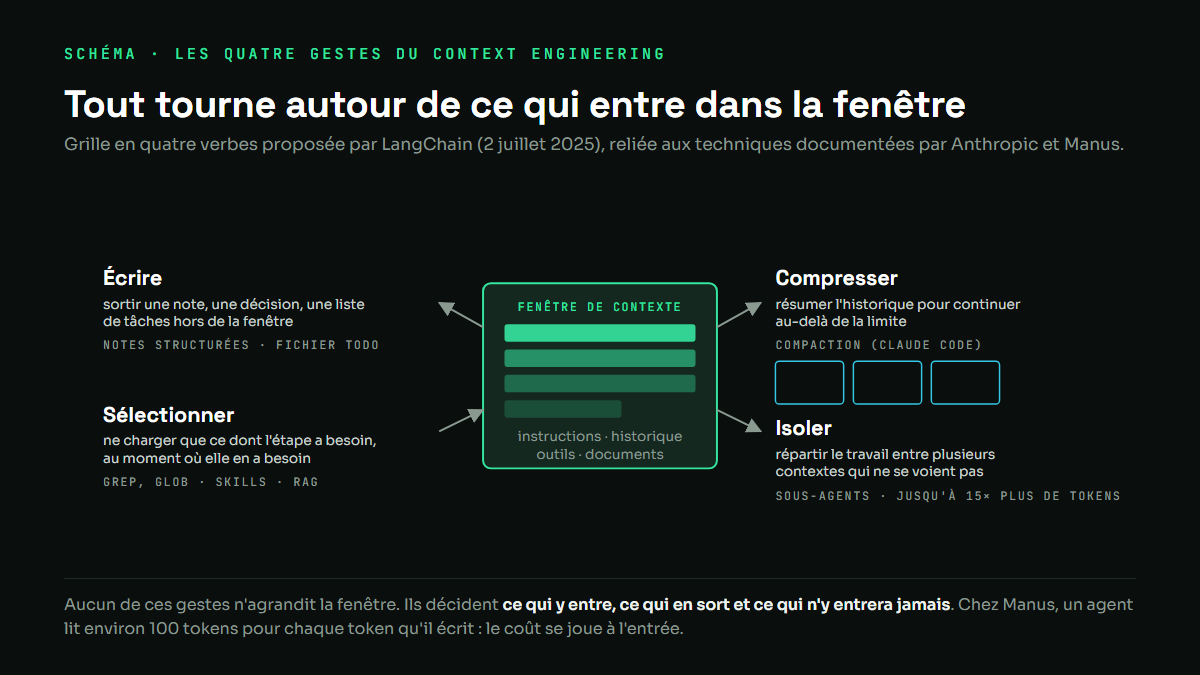
LangChain a proposé une grille en quatre verbes qui a l’avantage de tout ranger. Anthropic n’emploie pas ces mots, mais chacune de ses techniques tombe dans une case, et chacune existe dans un outil qu’on peut ouvrir.
| Geste | Ce que ça veut dire | Où ça existe, documenté |
|---|---|---|
| Écrire | sortir de l’information hors de la fenêtre pour la retrouver plus tard | les notes structurées d’Anthropic ; le fichier de tâches que Manus fait réécrire à son agent |
| Sélectionner | ne charger que ce dont l’étape a besoin, au moment où elle en a besoin | la récupération « just-in-time » par glob et grep dans Claude Code ; les skills, lus à la demande |
| Compresser | résumer l’historique pour continuer au-delà de la limite | la compaction de Claude Code, déclenchée à 95 % de la fenêtre selon LangChain |
| Isoler | répartir le travail entre plusieurs contextes séparés | les sous-agents du système de recherche multi-agents d’Anthropic |
Grille : LangChain, 2 juillet 2025. Incarnations : Anthropic, 29 septembre 2025, et Manus, 18 juillet 2025. Le geste le moins intuitif est le premier. Écrire un fichier de notes n’a rien de sophistiqué, et c’est pourtant le seul moyen de garder une décision prise au tour 12 encore visible au tour 200, une fois l’historique compressé.
Sur la sélection, Anthropic donne un exemple qui parle à quiconque a utilisé Claude Code : les fichiers CLAUDE.md sont « naïvement déposés dans le contexte dès le départ », tandis que les primitives de recherche laissent l’agent aller chercher les fichiers au moment utile. Deux stratégies opposées dans le même outil, assumées comme telles. Le RAG relève du même geste, à l’échelle d’une base documentaire.
Ce que ça coûte, chiffré par ceux qui le paient
Le billet le plus utile sur le sujet n’est pas celui d’un éditeur de modèles mais celui d’un éditeur d’agent. Yichao Ji, cofondateur de Manus, écrit le 18 juillet 2025 que son équipe a reconstruit quatre fois son cadre d’agent, et donne les chiffres que personne d’autre ne publie.
Chez Manus, une tâche demande environ 50 appels d’outils, et le rapport entre tokens entrés et tokens sortis avoisine 100 pour 1. Cent tokens lus pour un token écrit : c’est ça, un agent, et c’est pour ça que le prix se joue à l’entrée.
D’où sa métrique numéro un, « le taux de réussite du cache KV », qu’il appelle « la métrique la plus importante pour un agent en production ». Le motif est tarifaire : sur Claude Sonnet, le même auteur relève un token en cache à 0,30 dollar le million contre 3 dollars hors cache, dix fois moins.
Corollaire pratique et contre-intuitif : ne pas retirer un outil de la liste en cours de tâche, mais le masquer. Retirer un outil change le début du contexte, ce qui invalide le cache de tout ce qui suit. LangChain, de son côté, cite un chiffre qui tempère le geste « isoler » : le système multi-agents d’Anthropic consomme jusqu’à 15 fois plus de tokens qu’une conversation simple. Isoler coûte, et il faut que la tâche le vaille.
Le point que les formations survolent : on ne contrôle pas tout
Birgitta Böckeler, de Thoughtworks, a publié le 5 février 2026 sur le site de Martin Fowler une lecture du context engineering appliquée aux agents de code, avec une définition d’une sobriété reposante : « choisir ce que le modèle voit pour obtenir un meilleur résultat ». Son apport est ailleurs : elle distingue trois façons de faire entrer quelque chose dans le contexte.
Le modèle décide (il ouvre un skill parce que la demande correspond à sa description), l’humain décide (il tape une commande /), ou le logiciel décide, de façon déterministe, par un hook. Seul le troisième chemin garantit que quelque chose sera lu. Les deux autres restent probabilistes, et elle le dit sans détour : « tant que des LLM sont impliqués, nous ne pouvons jamais être certains de rien ».
C’est la phrase que j’aurais aimé lire dans les pages françaises qui vendent le context engineering comme une méthode. C’en est une, mais elle organise une incertitude, elle ne la supprime pas.
Sa recommandation finale va dans le même sens : construire sa configuration de contexte progressivement, en ajoutant ce qui manque quand on constate qu’il manque, plutôt que de tout charger d’avance « au cas où ». Le « au cas où » est exactement ce que l’étude de Chroma pénalise.
Ce que le terme établit, et ce qu’il n’établit pas
Ce que ça établit : le mot désigne un vrai problème d’ingénierie, mesuré (Chroma), chiffré (Manus), et outillé (compaction, notes, sous-agents, chargement à la demande). Il a déplacé la question de « comment formuler ma demande » vers « qu’est-ce que le modèle voit, et combien ça coûte ». Cette bascule est réelle et elle date de 2025.
Ce que ça n’établit pas : qu’il s’agisse d’une discipline avec ses règles stables. Les recommandations d’Anthropic sont des heuristiques, présentées comme telles ; Manus a changé d’architecture quatre fois en quelques mois ; et Böckeler prévient que les fonctionnalités qu’elle décrit ont changé pendant qu’elle écrivait. Le terme est utile. Le « guide complet » ne l’est pas encore, faute de matière stabilisée à mettre dedans.
Les questions qui reviennent
Quelle différence entre prompt engineering et context engineering ?
Le prompt engineering travaille la consigne ; le context engineering travaille tout ce que le modèle lit, consigne comprise : instructions système, historique, résultats d’outils, documents, exemples. Le premier est contenu dans le second. Anthropic le présente comme une « progression naturelle », pas comme un remplacement.
Le context engineering, c’est un métier ?
Le mot figure sur des fiches de poste, ce que je peux constater, et rien n’indique qu’il désigne un savoir-faire distinct de celui d’un ingénieur qui construit des agents. Ce que je peux dire : les compétences qu’il recouvre, mesurer ce qui entre, gérer un cache, découper une tâche, sont celles de l’ingénierie logicielle ordinaire appliquée à un composant probabiliste.
Faut-il un outil dédié pour faire du context engineering ?
Non. Les quatre gestes se font avec un système de fichiers, un résumé et une liste d’outils bien tenue. Manus décrit le système de fichiers comme son contexte « illimité en taille, persistant par nature ». Les cadres logiciels qui se présentent comme la solution en sont une mise en œuvre parmi d’autres, pas une condition.
À retenir
- Le context engineering consiste à choisir l’ensemble des tokens que le modèle lit à chaque étape, pas seulement la consigne. Le prompt en est une partie.
- Il existe parce que l’attention d’un modèle se dégrade avec la longueur du contexte, mesuré sur 18 modèles par Chroma en juillet 2025.
- Quatre gestes le résument : écrire, sélectionner, compresser, isoler, et chacun existe déjà dans un outil documenté (notes, chargement à la demande, compaction, sous-agents).
- Le coût se joue à l’entrée : environ 100 tokens lus pour 1 écrit chez Manus, et un token en cache dix fois moins cher qu’un token relu. Isoler en sous-agents peut multiplier la note par 15.
- Seul un déclenchement par le logiciel (hook) est certain ; ce que le modèle décide de lire reste probabiliste.