Tu as croisé le sigle RAG dans un article sur l’IA, ou dans le descriptif d’un outil qui promet de « répondre à partir de tes propres documents ». Derrière ces trois lettres se cache une idée simple, et plutôt saine. Regardons.
Le RAG, c’est quoi ?
RAG veut dire Retrieval-Augmented Generation, en français « génération augmentée par la recherche ». C’est une méthode qui autorise une IA à aller consulter une source extérieure (une base de documents, un site, une fiche produit) avant de formuler sa réponse, au lieu de puiser uniquement dans ce qu’elle a mémorisé pendant son entraînement.
En une phrase : plutôt que de répondre de mémoire, l’IA va d’abord chercher la bonne information, puis rédige à partir de ce qu’elle vient de trouver.
Le terme n’a rien d’un argument marketing récent. Il vient d’un article de recherche signé Patrick Lewis et ses coauteurs, publié en 2020. Cinq ans qu’il existe ; c’est son adoption massive qui est nouvelle, pas le concept.
Pourquoi ça existe : une IA seule, ça invente
Un modèle de langage classique, le moteur derrière ChatGPT ou ses concurrents, ne consulte rien quand il te répond. Il génère le texte le plus probable à partir de ce qu’il a appris, un mot après l’autre. La plupart du temps, ça suffit. L’ennui commence quand l’information ne figure pas dans sa mémoire, ou qu’elle a changé depuis son entraînement : le modèle ne dit pas « je ne sais pas », il produit une réponse plausible et fausse. C’est ce qu’on appelle une hallucination.
Le RAG vise exactement ce trou. Au lieu de laisser l’IA parier sur sa mémoire, on lui met la source sous les yeux au moment de la question. Elle n’a plus à deviner ce qu’elle ignore : elle lit, puis répond.
Une nuance de vocabulaire au passage, parce qu’on la confond souvent : le RAG n’est pas un modèle, c’est une tuyauterie autour du modèle. Le texte final, lui, c’est toujours un modèle de langage qui l’écrit.
Comment ça marche, en trois temps
Le sigle décrit l’ordre des opérations. Quand tu poses une question à un système RAG, il se passe ceci :
- Recherche (retrieval) : ta question sert à fouiller la base de documents pour en sortir les passages les plus proches.
- Augmentation : ces passages sont collés à ta question, comme un dossier qu’on glisserait au modèle avant l’entretien.
- Génération : le modèle rédige sa réponse en s’appuyant sur ce dossier, pas sur sa seule mémoire.
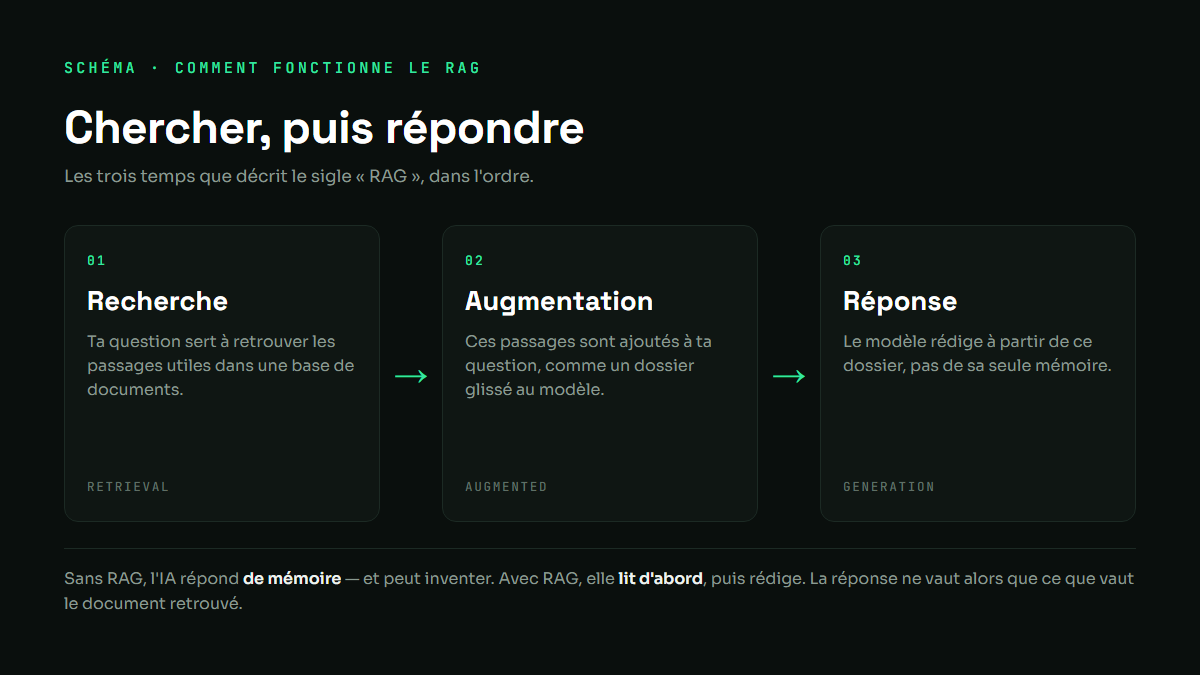
Retrieval, Augmentation, Generation : les trois mots derrière le sigle, dans l’ordre. Rien de magique là-dedans : on a juste donné à l’IA le droit de relire ses fiches avant de parler.
Un exemple concret
Prends le chatbot d’un site marchand. Sans RAG, tu lui demandes « votre montre X est-elle étanche ? » et il répond à partir de ce qu’il a vu en général sur les montres : il peut très bien se tromper sur ce modèle précis. Avec RAG, la même question déclenche une recherche dans la fiche produit réelle de la montre X, et le bot répond « oui, étanche jusqu’à 50 mètres » parce qu’il vient de lire la fiche.
C’est là que le RAG est réellement utile : brancher une IA sur une connaissance précise, à jour, qui t’est propre (la doc interne d’une entreprise, un catalogue, une base de textes de loi) sans avoir à réentraîner quoi que ce soit.
RAG ou fine-tuning ? La confusion la plus courante
On mélange souvent les deux, parce que tous deux servent à « spécialiser » une IA. Ce ne sont pas les mêmes gestes.
Le fine-tuning réentraîne le modèle sur tes données : tu modifies sa mémoire interne, une bonne fois, et il faut recommencer (à un certain coût) dès que les données changent. Le RAG, lui, ne touche pas au modèle ; il lui ouvre l’accès à une source qu’on peut mettre à jour quand on veut, sans rien réentraîner.
Une règle simple pour t’y retrouver : le fine-tuning change la façon dont l’IA répond, son style, son format ; le RAG change ce qu’elle sait au moment de répondre. Pour une documentation qui bouge souvent, le RAG est presque toujours le bon choix.
Est-ce que le RAG supprime vraiment les hallucinations ?
C’est ici qu’il faut séparer ce qui est démontré de ce qui est vendu. Le RAG réduit les hallucinations, ça, c’est établi : donner la source au modèle l’empêche de parier dans le vide. Mais « réduire » n’est pas « supprimer ».
Une synthèse publiée dans la revue Mathematics en mars 2025 recense les cas où le RAG dérape quand même : si la recherche ramène le mauvais document, ou un passage ambigu, le modèle rédige une réponse fausse avec l’aplomb de quelqu’un qui cite ses sources. Le problème s’est déplacé, il n’a pas disparu : la qualité de la réponse dépend maintenant de la qualité de ce qu’on récupère.
Alors quand un outil te promet « zéro hallucination grâce au RAG », traduis : moins d’hallucinations, à condition que la base soit propre et la recherche bien réglée. C’est déjà beaucoup. Ce n’est pas la même phrase.
À retenir
- Le RAG fait aller l’IA chercher l’info dans une source fiable avant de répondre, au lieu de puiser dans sa seule mémoire.
- Il sert surtout à brancher une IA sur une connaissance précise et à jour (doc interne, catalogue) sans la réentraîner. C’est là sa vraie valeur, plus que dans le fine-tuning pour ce cas.
- Il réduit les hallucinations sans les supprimer : la réponse ne vaut jamais mieux que la source récupérée.