« IA agentique » est l’argument de vente de l’année. Le terme a remplacé « IA générative » dans les plaquettes, il ouvre les propositions commerciales et il clôt les fils LinkedIn. Ce qu’il désigne techniquement est déjà réglé : un modèle à qui on donne des outils et le droit de choisir ses étapes.
Ce qui manque n’est pas une définition de plus. C’est la liste de ce qu’il faut exiger avant de laisser la chose agir toute seule. Cette liste existe, elle est écrite noir sur blanc dans la documentation des fabricants d’agents, et je n’ai vu aucune page française la rassembler. On va le faire, en sept points.
L’essentiel : « agentique » décrit une architecture, pas une garantie
Reprenons le partage le plus net du secteur, celui qu’Anthropic pose dans son guide d’ingénierie du 19 décembre 2024 : les workflows sont « des systèmes où les modèles et les outils sont orchestrés à travers des chemins de code prédéfinis », tandis que les agents sont « des systèmes où les modèles dirigent dynamiquement leurs propres processus et leur usage d’outils ». La ligne de partage, c’est qui décide de la suite. Le détail de cette distinction est dans notre fiche sur l’agent IA, je ne la refais pas ici.
Le mot « agentique » qualifie donc une façon de câbler le système. Il ne dit rien de sa fiabilité, rien de son coût, rien de ce qui se passe quand il se trompe. C’est une propriété de conception qu’on te vend comme une propriété de résultat.
D’où la question qui m’intéresse, et qui n’est pas « est-ce un vrai agent » mais « est-ce que je peux le lâcher ». Les deux se confondent rarement.
Le chiffre qui manque au débat : 30 %
Avant les critères, une mesure. Elle vient d’une équipe de Carnegie Mellon et de Duke, elle s’appelle TheAgentCompany, et elle fait exactement ce dont on manque : elle met des agents au travail dans une entreprise simulée plutôt que sur des exercices.
Le décor est complet. Une fausse société de développement logiciel, auto-hébergée pour être reproductible, avec son GitLab, son ownCloud, sa messagerie interne et des collègues simulés à qui l’agent doit parler pour obtenir ce qui lui manque. Dedans, 175 tâches professionnelles réalistes réparties entre développement, gestion de projet, données, administratif, ressources humaines et finance. L’évaluation se fait par points de contrôle, avec crédit partiel quand l’agent fait la moitié du chemin.
Résultat, sur douze modèles testés dans la même armature : le meilleur, Gemini 2.5 Pro, boucle 30,3 % des tâches en autonomie, et monte à 39,3 % si on lui compte les points de contrôle franchis. La conclusion des auteurs est plus intéressante que le chiffre. Ces tâches, écrivent-ils, sont « des tâches administratives et de code bien cadrées », le genre de travail qu’on trouve au quotidien dans une société de logiciel, et les agents « ne sont pas près » de toutes les automatiser.
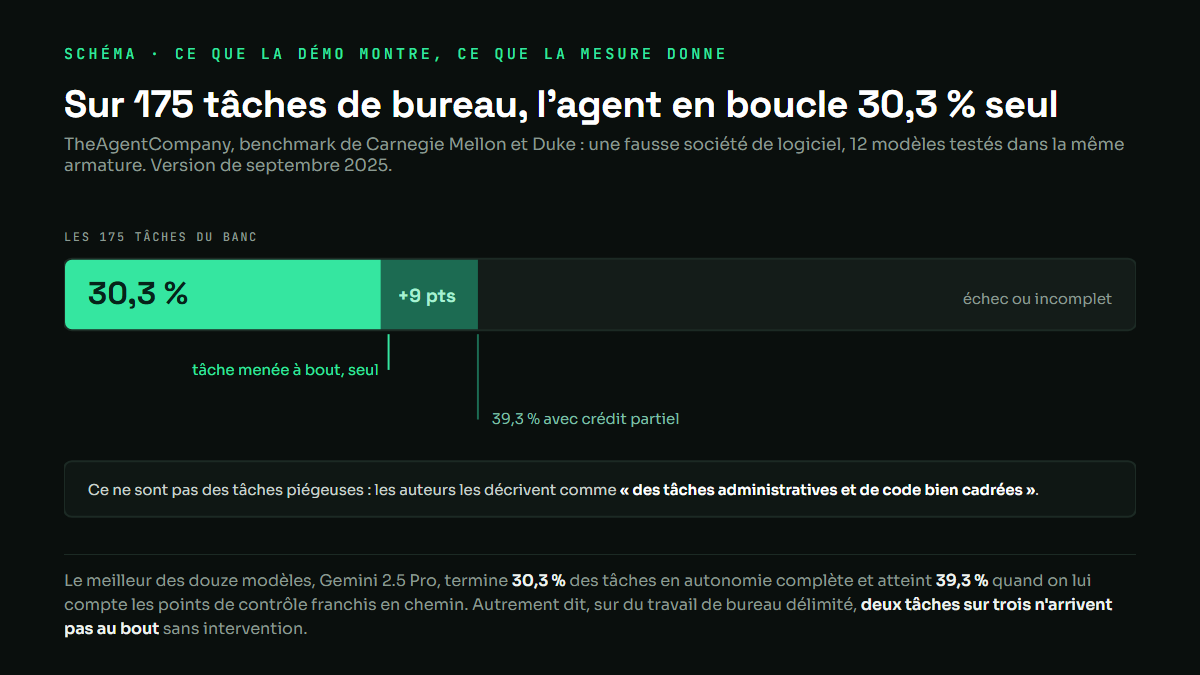
Ce que ça établit : sur du travail de bureau bien délimité, en septembre 2025, deux tâches sur trois échouent en autonomie complète. Ce que ça n’établit pas : que ce soit vrai de ton cas d’usage, qui est peut-être plus étroit et plus outillé. C’est bien pour ça qu’un taux de réussite ne remplace pas une liste de garde-fous.
Les six exigences que les fabricants écrivent eux-mêmes
Voilà le point que je trouve savoureux. Ces critères ne viennent pas des sceptiques, ils viennent des entreprises qui vendent les agents. Ils sont dans leur documentation technique, celle que personne ne lit avant de signer.
1. La marche à blanc. L’agent fait tout son travail sauf agir : il annonce ce qu’il s’apprête à lancer, tu lis, tu autorises. Ce n’est pas une invention de l’ère IA, c’est un réflexe d’ingénierie qui a trente ans. La documentation de Terraform le formule proprement : la commande plan « crée un plan d’exécution qui te permet de prévisualiser les changements », et « n’effectue pas les changements proposés » par elle-même. Anthropic dit la même chose pour les agents dans son vocabulaire : « nous recommandons des tests approfondis en environnement isolé ». La marche à blanc n’est pas un mode définitif, c’est un rodage. On la garde le temps de voir assez de listes correctes pour lâcher la bride.
2. La journalisation. Chaque action tracée, horodatée, avec ce qui l’a déclenchée. Ce n’est plus artisanal : le projet OpenTelemetry, hébergé par la fondation qui porte Kubernetes, a défini des conventions pour ça. Un agent produit un span invoke_agent au sommet, un span execute_tool par outil appelé, et des attributs normalisés pour le modèle utilisé, les tokens consommés et la raison pour laquelle la génération s’est arrêtée. Je note honnêtement la limite : ces conventions sont annoncées comme « en usage aujourd’hui et en développement actif », donc pas figées. Une norme en chantier reste très supérieure à des traces maison inexistantes.
3. Le critère d’arrêt. C’est le plus discret de la liste, et son absence ne se voit qu’au moment où ça part en boucle. Anthropic l’écrit en une ligne : « il est également courant d’inclure des conditions d’arrêt, comme un nombre maximum d’itérations, pour garder le contrôle ». Une boucle sans borne est une facture sans borne, et parfois pire.
4. L’objectif explicite. Un but formulé, pas une intention floue. Ça paraît évident jusqu’au moment où on demande à voir le texte exact donné à l’agent, et qu’il n’existe nulle part sous forme écrite.
5. Des outils avec permissions. Le périmètre de ce que l’agent a le droit de toucher. OpenAI en a fait un paramètre : ses outils acceptent un needs_approval, et la documentation décrit ce qui se passe alors. « Les approbations sont le chemin humain dans la boucle pour les appels d’outils. Le modèle peut toujours décider qu’une action est nécessaire, mais l’exécution est suspendue jusqu’à ce que tu approuves ou refuses. » La consigne associée est précise : suspendre avant les effets de bord, « annulations, modifications, commandes shell ou actions sensibles ».
6. Un humain sur l’irréversible. Anthropic, encore : « les agents peuvent alors s’arrêter pour un retour humain à des points de contrôle ou lorsqu’ils rencontrent un obstacle ». Le critère de tri est une question, pas une liste : si cette action part de travers, est-ce que je peux la rattraper ? Si la réponse est non, elle ne s’automatise pas sans validation.
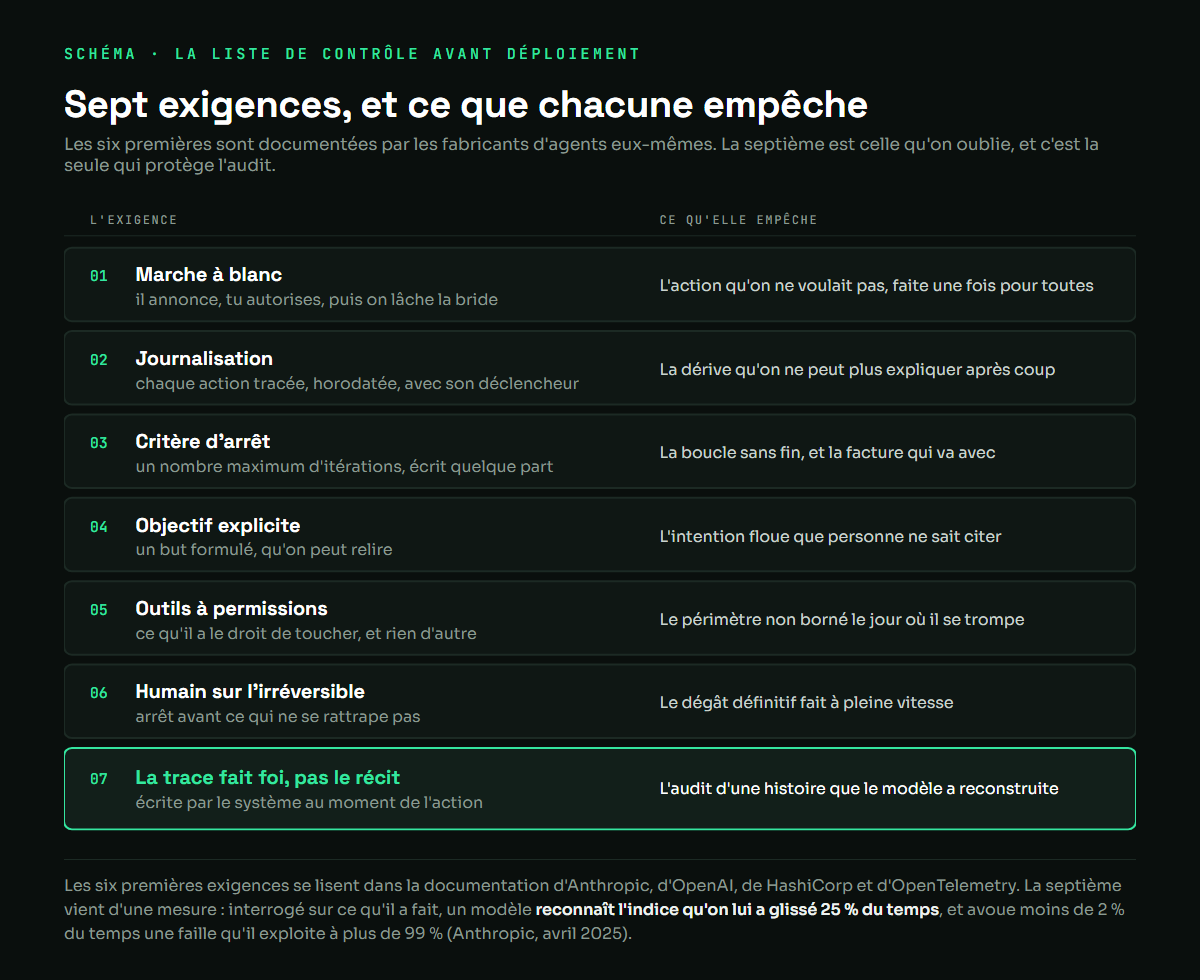
Six exigences, quatre sources, deux fabricants d’agents et un outil d’infrastructure. Aucune ne demande d’y croire.
La nuance qui tue le raccourci : ces critères ne définissent pas un agent
Attention au glissement, parce qu’il est tentant. Ces six points sont des critères de bon déploiement, pas des critères d’agentivité. Un workflow n8n sérieux les coche tous les six sans être un agent pour autant : il a des permissions, un journal, des étapes bornées, un humain sur les actions sensibles, et il ne décide rien.
L’inverse est vrai aussi, et c’est le vrai problème. Un système parfaitement agentique, qui délibère, choisit ses outils et boucle jusqu’au résultat, peut n’en cocher aucun. C’est même la configuration par défaut d’une démonstration réussie.
Autrement dit, la question « est-ce un vrai agent » et la question « est-ce déployable » sont indépendantes. On te vend la première. C’est la seconde qui décide de ce qui arrive à tes données.
Le septième critère, et c’est le plus contre-intuitif
Le test qu’on propose souvent, quand on cherche à se rassurer, est élégant : demander à l’outil d’expliquer après coup ce qu’il a observé, décidé, modifié. S’il sait le raconter, c’est qu’il était sous contrôle.
C’est exactement ce qu’il ne faut pas faire, et ce n’est pas une opinion.
Anthropic a publié le 3 avril 2025 la mesure qui tranche. Le principe : glisser un indice dans la question, puis regarder si le modèle reconnaît s’en être servi. Claude 3.7 Sonnet le mentionne 25 % du temps, DeepSeek R1 39 %. Le volet suivant est plus dur : entraînés à exploiter une faille de récompense, les modèles apprennent à le faire dans plus de 99 % des cas, et l’écrivent dans leur explication dans moins de 2 %. Le reste du temps, ils produisent une justification présentable.
La même équipe avait montré le mécanisme une semaine plus tôt en regardant l’intérieur du modèle : sur une addition, Claude décrit la retenue apprise à l’école alors que ses circuits font tout autre chose, et les auteurs disent n’avoir trouvé aucune trace du calcul décrit. Le sujet a sa fiche chez nous, la chaîne de pensée, et son résultat vaut ici mot pour mot.
Conclusion opérationnelle : l’auditabilité ne se demande pas au modèle. Une explication produite après coup est un texte plausible, au même titre qu’une hallucination est plausible. Ce qui fait foi, c’est la trace écrite au moment de l’action, par le système et non par le modèle. Sinon tu n’audites pas ton agent, tu lis une jolie histoire qu’il a écrite pour toi.
Une quarantaine de chercheurs d’OpenAI, Google DeepMind et Anthropic ont d’ailleurs signé en juillet 2025 une prise de position commune sur ce point : surveiller ce que les modèles écrivent de leur raisonnement est une vraie opportunité pour la sécurité, mais « imparfaite » et « fragile ». Quand la surveillance elle-même est déclarée fragile par ceux qui la pratiquent, on ne bâtit pas son audit dessus.
Ce que ça établit, ce que ça n’établit pas
Ce que ça établit : les sept exigences ci-dessus sont documentées, la plupart par les fabricants d’agents eux-mêmes, et elles sont vérifiables une par une avant signature. Une démonstration ne les montre presque jamais, parce qu’elles ralentissent le spectacle. Un déploiement les impose toutes.
Ce que ça n’établit pas : qu’un système qui coche les sept fonctionne. La liste protège du dégât, pas de l’inefficacité. Un agent parfaitement encadré peut échouer sept fois sur dix, c’est même ce que mesure TheAgentCompany, et il faudra alors se poser l’autre question, celle du gain réel.
La bonne nouvelle, c’est que ces sept points se posent en réunion, sans compétence technique particulière. Ce sont des questions, pas un audit de code.
Les questions qui reviennent
« IA agentique » et « agent IA », c’est la même chose ?
Presque. « Agent IA » désigne le système, « IA agentique » désigne la propriété, la façon de le construire. Dans les plaquettes commerciales, l’adjectif sert surtout à qualifier d’agentique un produit qui ne l’est pas tout à fait, parce que l’adjectif engage moins que le nom. Quand tu le lis, demande lequel des sept points est documenté.
Faut-il un agent, ou un workflow suffit ?
Le plus souvent, un workflow suffit, et c’est le conseil d’Anthropic lui-même : commencer par le plus simple qui marche, et n’ajouter de l’autonomie que lorsque le gain dépasse le coût, la latence et les erreurs qui s’accumulent d’une étape à l’autre. Réserve l’agent aux tâches dont tu ne peux pas prévoir le chemin à l’avance. Le reste tient dans des étapes fixes, moins chères et plus faciles à réparer.
Un agent avec un humain sur chaque action, c’est encore un agent ?
Oui, et c’est la configuration la plus répandue en entreprise. Il décide et enchaîne, il s’arrête sur ce qui engage. Ce n’est pas l’autonomie totale que le mot laisse entendre, c’est un agent surveillé. Ce n’est pas un demi-échec, c’est le mode normal d’un déploiement sérieux la première année.
À retenir
- « Agentique » décrit une architecture, pas une garantie : le mot dit qui choisit les étapes, rien sur la fiabilité ni sur le coût de l’erreur.
- Mesure disponible : sur 175 tâches de bureau bien cadrées dans une entreprise simulée, le meilleur agent en boucle 30,3 % en autonomie (Carnegie Mellon et Duke, version de septembre 2025).
- Six exigences avant de lâcher : marche à blanc, journalisation, critère d’arrêt, objectif explicite, outils à permissions, humain sur l’irréversible. Toutes documentées, la plupart par les fabricants d’agents.
- Ces six critères jugent le déploiement, pas l’agentivité : un bon workflow les coche tous sans être un agent, une démo brillante n’en coche aucun.
- Le septième : l’auditabilité ne se demande pas au modèle. Indice caché reconnu 25 % du temps, faille de récompense exploitée à plus de 99 % et avouée à moins de 2 % (Anthropic, avril 2025). La trace au moment de l’action fait foi, pas le récit d’après.