Bon. Tu as installé Ollama, tu lui as posé trois questions dans sa fenêtre, tu as trouvé ça marrant, et puis tu l’as laissé dormir. C’est exactement là que je me suis arrêté la première fois. Le problème d’une IA locale, c’est qu’elle attend qu’on lui parle : elle ne va rien chercher, elle ne range rien, elle ne fait rien pendant que tu dors.
n8n règle ça. C’est l’outil qui enchaîne les actions à ta place, et il tourne lui aussi sur ta machine. Le mariage des deux donne une petite chaîne de montage privée : quelque chose entre (un texte, un mail, un fichier), l’IA le traite, un résultat sort. Rien ne quitte le PC.
On va construire le plus simple des trois nœuds qui existent, et je te préviens tout de suite : ça n’a pas marché du premier coup chez moi non plus. Les deux endroits où ça casse sont toujours les mêmes, et aucun des deux n’est de ta faute.
Ce qu’on va construire : un résumeur qui ne sort pas de chez toi
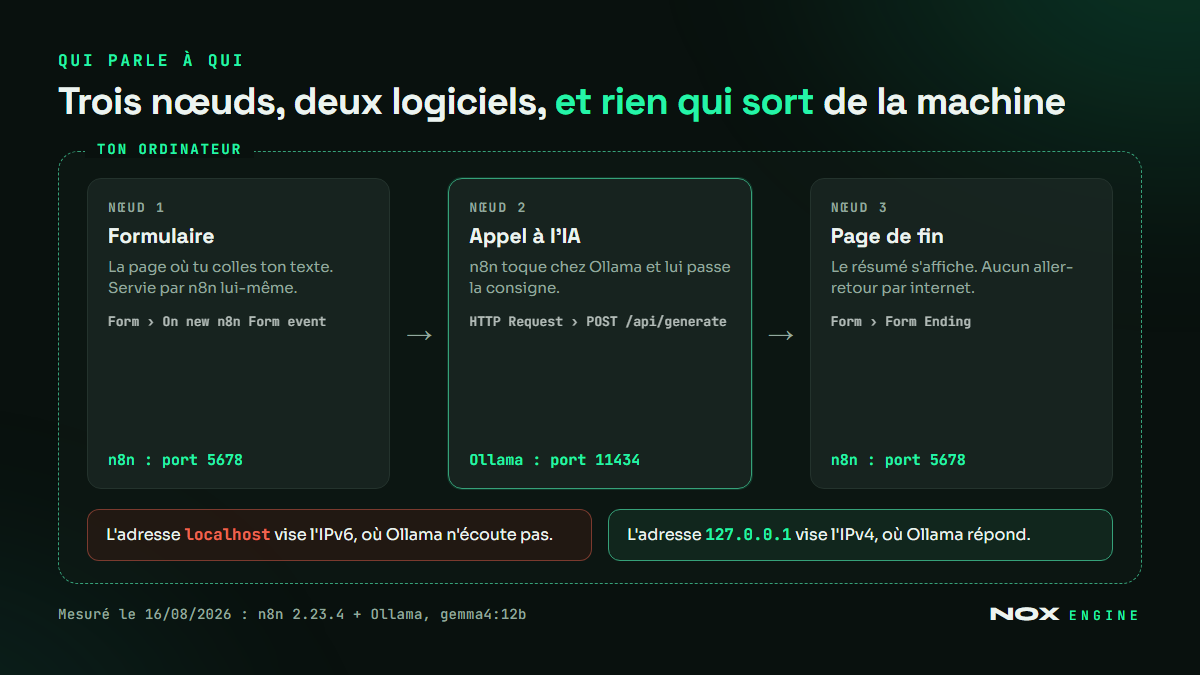
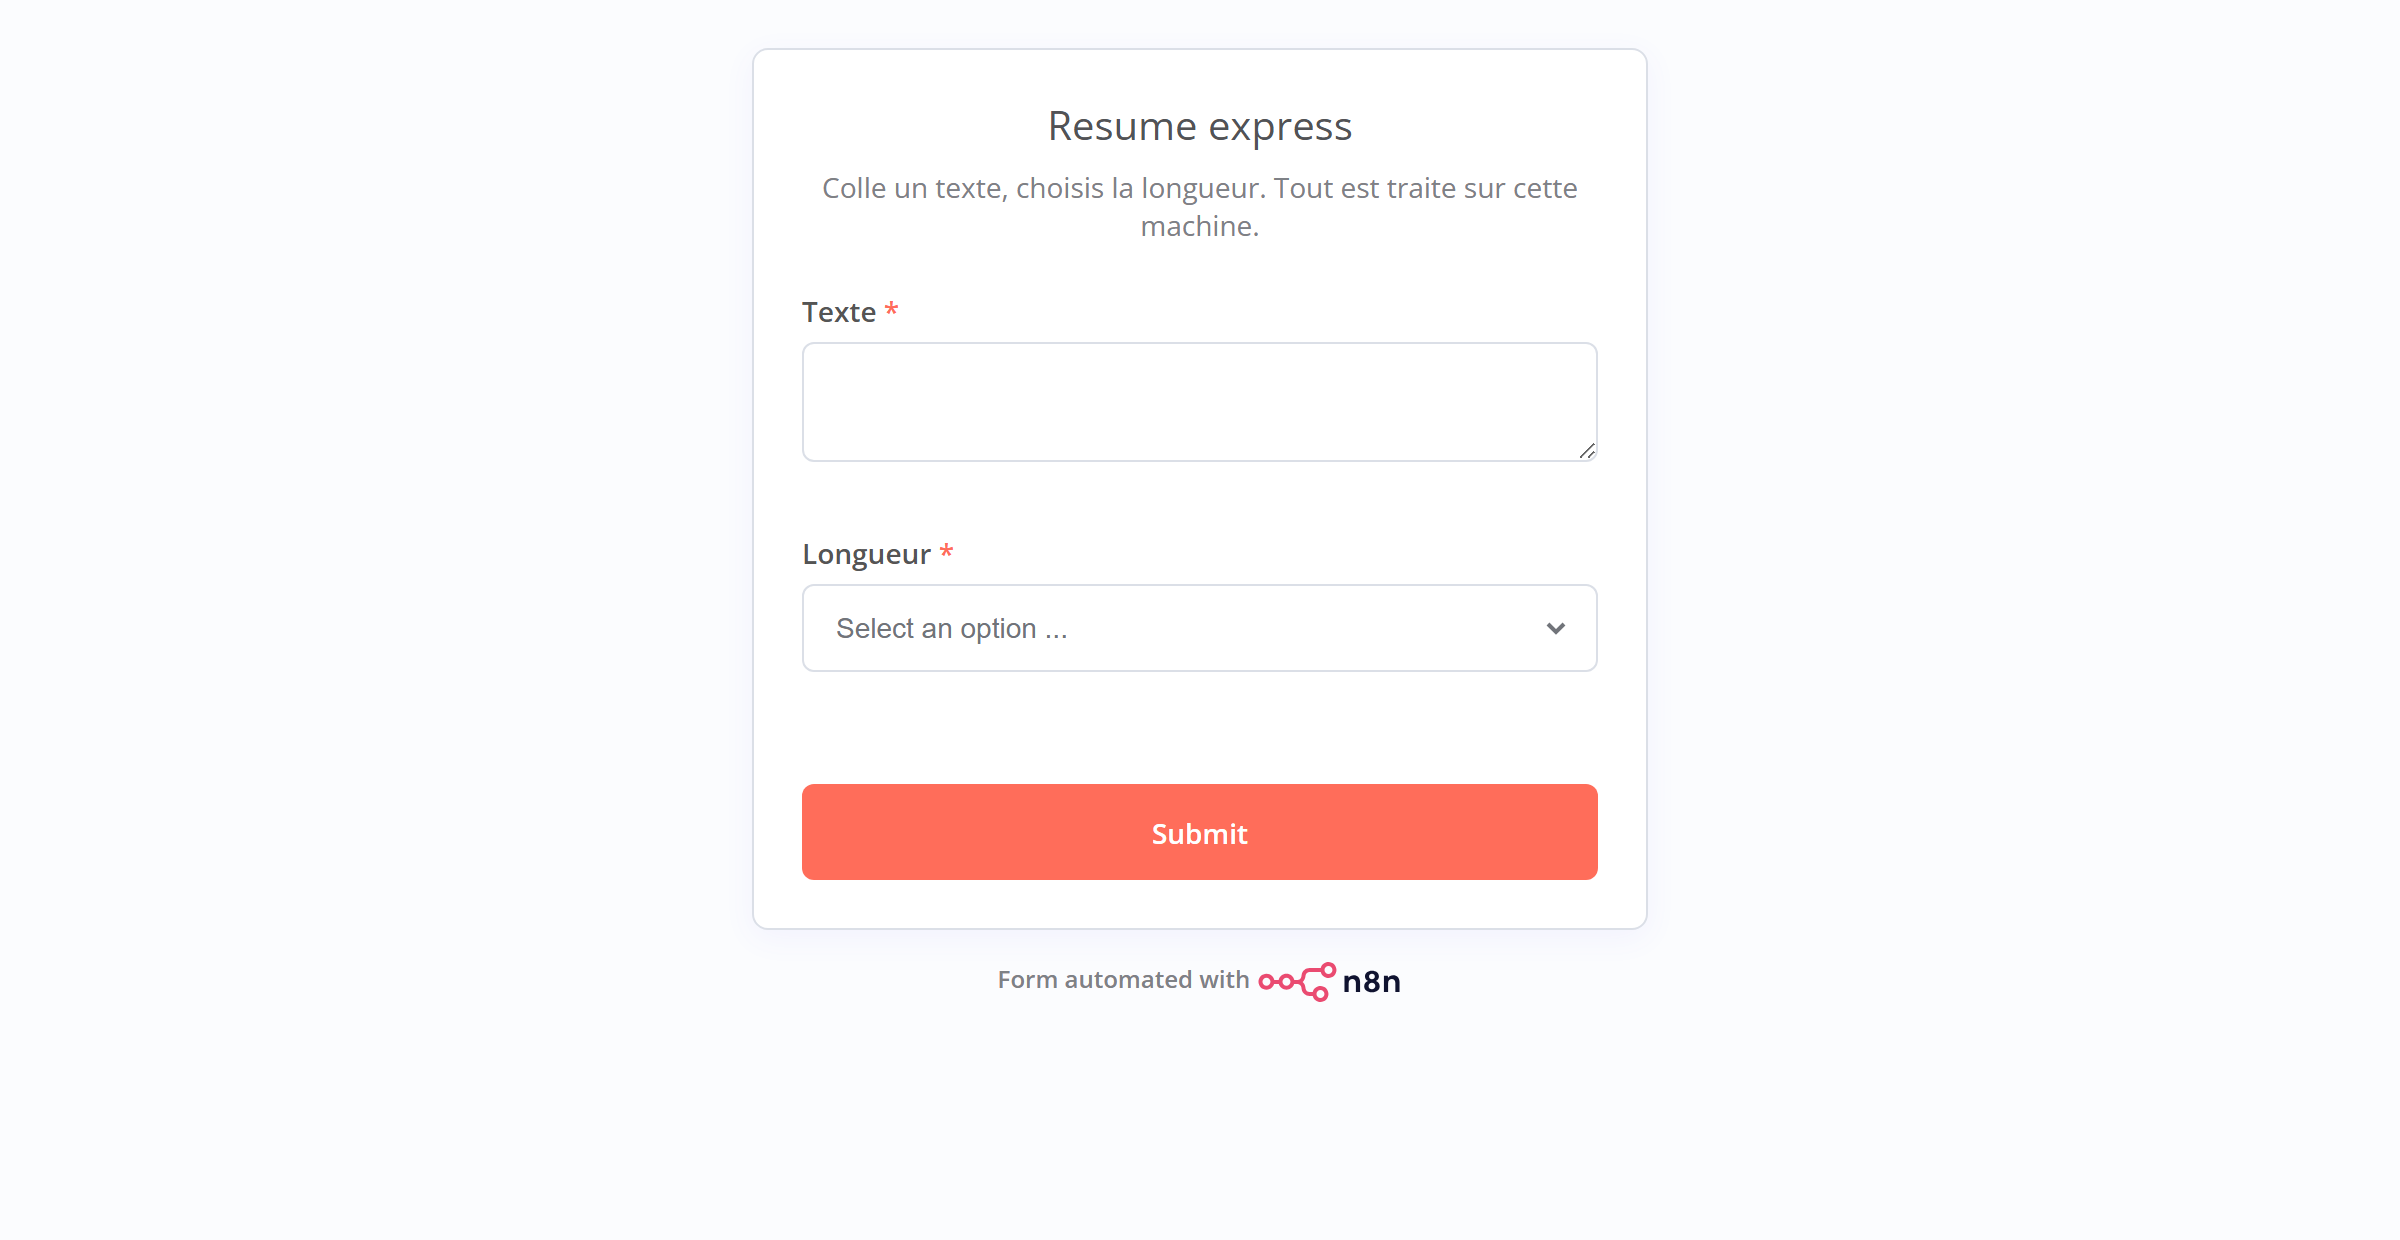
Le chantier du jour : une page web, hébergée par ta propre machine, avec un champ où tu colles un texte et un menu pour choisir la longueur du résumé. Tu valides, l’IA locale mâche, la réponse s’affiche. Trois nœuds, pas un de plus.
Pourquoi celui-là plutôt qu’un truc plus impressionnant ? Parce qu’il contient déjà tout ce qui pose problème (le déclencheur, l’appel au modèle, l’affichage du résultat) et qu’il produit un objet réellement utilisable à la fin. Une fois qu’il tourne, tu remplaces le formulaire par un mail entrant ou un dossier surveillé et tu as compris n8n.
Ce qu’il te faut avant de commencer : Ollama installé avec au moins un modèle (si ce n’est pas fait, la version pas à pas de l’installation est ici, ça prend cinq minutes), et une idée vague de ce qu’est n8n. Pas besoin de Docker. Pas besoin de serveur. Pas besoin de Linux.
Étape 1 : vérifier qu’Ollama répond vraiment
Avant de brancher quoi que ce soit, on s’assure que le moteur tourne. Ollama installe un petit serveur qui écoute en permanence sur le port 11434 de ta machine, et c’est ce serveur que n8n va appeler, pas la fenêtre de discussion. Les deux sont indépendants : tu peux fermer la fenêtre, le serveur continue.
Ouvre un terminal (touche Windows, tape « powershell », Entrée) et demande-lui la liste de ce qui est installé :
ollama list
Tu dois voir tes modèles avec leur taille. Si la commande te répond une erreur, Ollama n’est pas lancé : cherche l’icône de lama à côté de l’horloge, ou relance l’application. Deuxième vérification, celle qui compte vraiment, parce qu’elle interroge le serveur au lieu du programme :
curl http://127.0.0.1:11434/api/tags
Un gros paquet de texte en accolades doit s’afficher. C’est moche, c’est normal, c’est la liste de tes modèles au format que comprennent les machines. Si tu as ça, la moitié du travail est faite : n8n saura parler à Ollama.
Note bien cette adresse, 127.0.0.1, et pas localhost. Je reviens dessus à l’étape 4, c’est le piège numéro un de tout ce tutoriel.
Étape 2 : lancer n8n sur ta machine
n8n s’installe avec Node.js, en une commande, et se lance en une autre. Rien à compiler, rien à configurer.
npm install -g n8n
n8n start
La première commande télécharge l’outil (compte quelques minutes, c’est un gros paquet). La seconde le démarre et te laisse la fenêtre ouverte : tant qu’elle est ouverte, n8n tourne ; si tu la fermes, il s’arrête. Au bout d’une minute environ, la ligne qui t’intéresse s’affiche :
Editor is now accessible via:
http://localhost:5678
Ouvre cette adresse dans ton navigateur. La première fois, n8n te demande de créer un compte : c’est un compte local, il ne part sur aucun serveur, mets ce que tu veux du moment que tu le retiens. Tu arrives sur une page vide avec un bouton pour créer ton premier workflow.
Petit repère de version, parce que ça a son importance dans deux minutes : la version que j’ai fait tourner pour cet article est la 2.23.4. Si la tienne commence par un 1, l’étape 6 ne ressemblera pas à ce que je décris, et tu n’es pas fou.
Étape 3 : le formulaire d’entrée
Dans un workflow vide, le premier nœud est toujours un déclencheur : la chose qui décide quand tout le reste part. On prend le formulaire, parce qu’il fabrique une vraie page web sans écrire une ligne de HTML.
Ajoute un nœud, cherche Form, choisis On new n8n Form event. Puis remplis :
- Form Path :
resume-express. C’est ce qui apparaîtra dans l’adresse de ta page. - Form Title : ce que tu veux, il s’affiche en gros en haut.
- Form Fields : deux champs. Le premier s’appelle
Texte, en type Textarea (la grande zone où on colle). Le second s’appelleLongueur, en type Dropdown, avec deux options :courtetdetaille.
Retiens les noms exacts que tu donnes aux champs, majuscules comprises. Le nœud suivant ira chercher leur contenu par ce nom, et une majuscule qui manque suffit à tout casser (oui, j’ai perdu du temps là-dessus, une autre fois, sur un autre projet).
Étape 4 : brancher Ollama, et là ça casse
Deuxième nœud : HTTP Request. C’est le nœud passe-partout de n8n, celui qui va toquer à une adresse et rapporter la réponse. On lui demande d’appeler le serveur Ollama.
- Method :
POST - URL :
http://127.0.0.1:11434/api/generate - Send Body : activé, en JSON
Dans le corps, on envoie trois choses au modèle : lequel on veut, la consigne, et le fait qu’on veut la réponse d’un bloc plutôt que mot à mot.
{
  "model": "gemma4:12b",
  "stream": false,
  "prompt": "Resume le texte suivant en francais, en deux phrases maximum. Ne commente pas, ne rajoute rien.\n\nTEXTE :\n{{ $json.Texte }}"
}
Les doubles accolades, c’est la manière dont n8n va chercher une valeur venue du nœud précédent : ici, le contenu du champ Texte de ton formulaire. Le "stream": false évite de recevoir la réponse par petits morceaux, ce qui compliquerait l’affichage pour rien.
Et maintenant le piège. Si tu écris localhost au lieu de 127.0.0.1 dans l’URL, n8n te renvoie une erreur de connexion refusée, alors que ton IA tourne parfaitement et que tu viens de le vérifier au terminal. On a tous cru à un problème de pare-feu, de droits, d’antivirus.
Ce n’est rien de tout ça. Sur Windows, localhost est traduit en priorité vers l’adresse moderne ::1 (de l’IPv6), or Ollama n’écoute que sur l’ancienne, 127.0.0.1 (de l’IPv4). Les deux désignent bien ta machine, mais par deux portes différentes, et l’IA n’attend que derrière une des deux. n8n frappe à la mauvaise, personne ne répond, il conclut que rien ne tourne. C’est documenté noir sur blanc dans la page des problèmes courants de n8n, ce qui ne l’empêche pas de faire abandonner la moitié des gens qui essaient.
Règle simple à retenir pour toute la suite de ta vie avec n8n : quand tu appelles un service qui tourne sur ta propre machine, écris toujours l’adresse en chiffres.
Étape 5 : afficher la réponse
Troisième et dernier nœud : re-cherche Form, et prends cette fois l’action Form Ending. C’est la page de fin, celle qui s’affiche une fois le travail terminé.
Un seul réglage compte, le message : mets-y {{ $json.response }}. Ollama range toujours son texte dans un champ nommé response, et on se contente de le recopier tel quel dans la page.
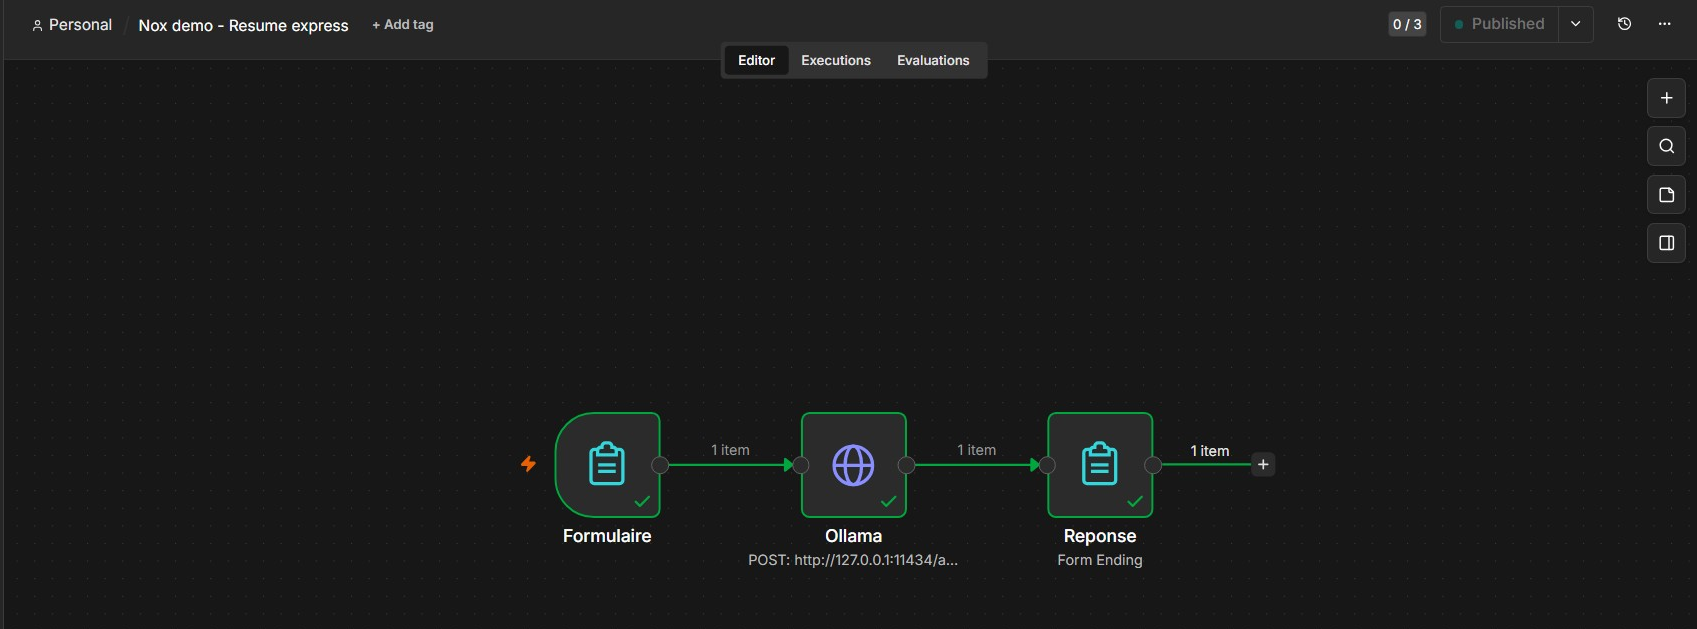
Relie les trois nœuds de gauche à droite en tirant sur les petits ronds. Formulaire, puis Ollama, puis la page de fin. C’est fini, ton workflow est écrit.
Étape 6 : publier, et pas activer
Voilà le deuxième endroit où tout le monde se plante, et cette fois ce n’est pas un piège technique : c’est un changement récent que la plupart des tutoriels en ligne n’ont pas encore intégré.
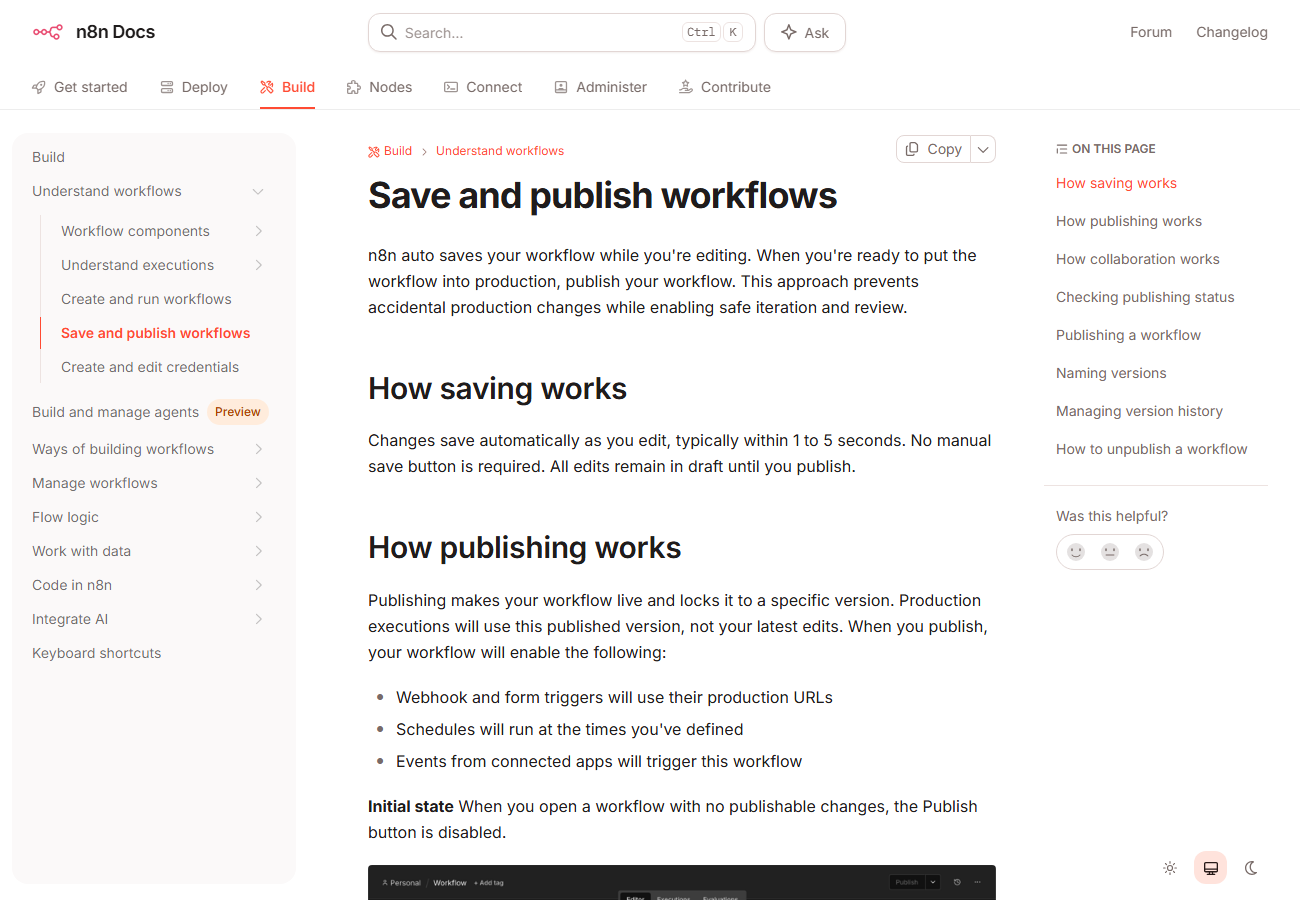
Avant, un workflow s’activait avec un interrupteur en haut à droite. Depuis la version 2 de n8n, ce n’est plus ça. Tout ce que tu modifies reste dans une version de travail, et il faut cliquer sur Publish (le raccourci Shift + P marche aussi) pour la mettre en service. La documentation le dit sans détour : « All edits remain in draft until you publish », tout reste en brouillon tant que tu n’as pas publié, et publier verrouille le workflow sur une version précise.
Concrètement : tant que tu n’as pas publié, ta page de formulaire n’existe pas. Tu ouvres son adresse, tu reçois une erreur 404, et le terminal de n8n te dit exactement ceci :
Received request for unknown webhook: The requested webhook "GET resume-express" is not registered.
J’ai eu ce message une dizaine de fois de suite en cherchant midi à quatorze heures. Le workflow existait, il était marqué comme actif, et sa page n’existait pas. C’est la publication qui manquait, rien d’autre. Sache d’ailleurs que le problème est plus retors qu’il n’y paraît si tu pilotes n8n de l’extérieur : plusieurs tickets ouverts signalent qu’activer un workflow par l’API ne le publie pas pour autant. Dans l’interface, un clic suffit.
Une fois publié, retourne sur le nœud Formulaire : il affiche l’adresse de ta page. Et là, petite surprise, elle ne ressemble pas au chemin que tu as tapé dans Form Path. n8n y colle un identifiant qu’il a fabriqué tout seul :
http://localhost:5678/form/2f8c1a94-7b30-4c11-9e62-8ad5f1c07b43
Il y en a même deux, et savoir laquelle tu regardes évite une demi-heure de confusion. L’adresse en /form-test/ sert pendant que tu bricoles : elle affiche un bandeau « This is a test version of your form » et n’attend qu’une seule soumission, le temps d’une exécution manuelle. L’adresse en /form/ est la vraie, celle qui répond en permanence tant que le workflow est publié. C’est celle-là que tu copies.
Ce que ça donne vraiment (et combien de temps ça prend)
Je lui ai donné un paragraphe de 110 mots sur le télétravail et le recrutement, en demandant la version courte. Voici ce que gemma4:12b a renvoyé, sans retouche :
Le télétravail élargit le bassin de candidats en supprimant les limites géographiques, tout en intensifiant la concurrence. Pour gérer ce volume de candidatures et fidéliser leurs équipes, certaines entreprises réintroduisent des jours de présence obligatoire.
Franchement, c’est bon. Français correct, aucune invention, la nuance du texte d’origine est gardée. Maintenant le chiffre qui refroidit : 19,8 secondes. Pour 110 mots. Sur une machine qui n’a rien d’un serveur.
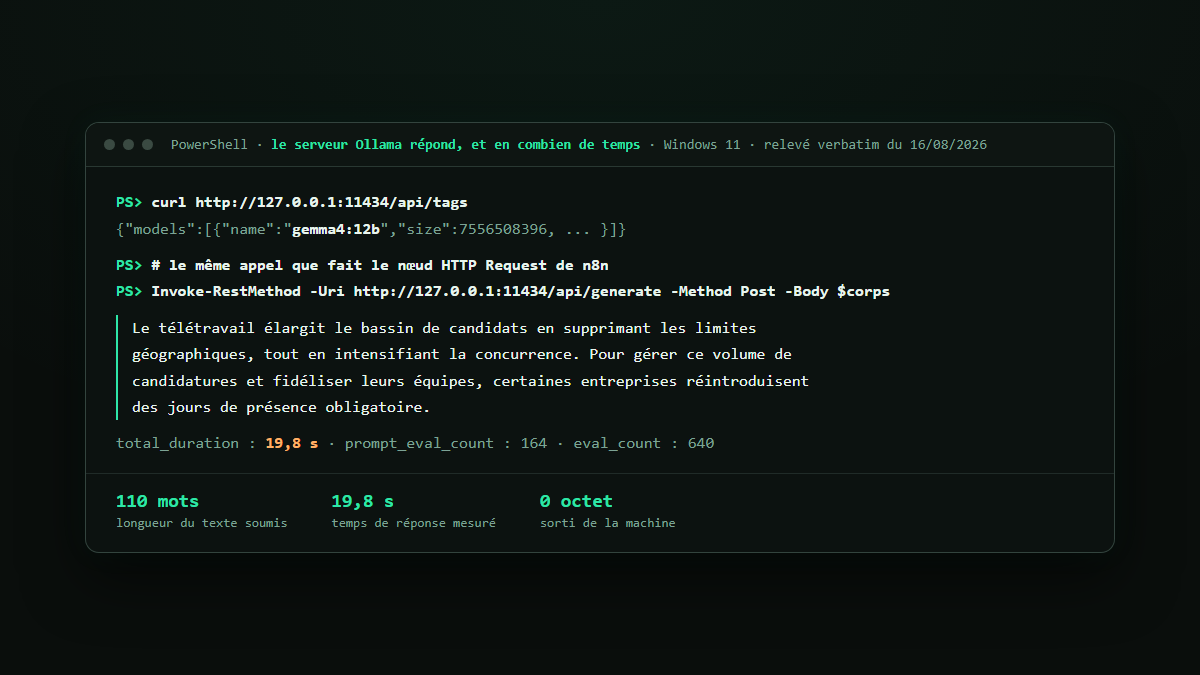
C’est la vérité de l’IA locale et personne ne te la dit assez fort : ça marche, mais ça prend le temps que ça prend. Un service en ligne t’aurait répondu en deux secondes. Ici, tu échanges de la vitesse contre le fait que ton texte ne sorte jamais de la pièce. Selon ce que tu traites, l’échange est excellent ou ridicule, et c’est à toi de trancher au cas par cas.
Et l’appel au modèle n’est pas tout. Mesuré dans n8n, le workflow complet, de la validation du formulaire à l’affichage du résumé, met 24,8 secondes. Le modèle en consomme 19,8, les cinq autres partent dans la plomberie. Rien de dramatique, mais retiens le principe : le temps que tu vois dans ton navigateur n’est jamais celui du modèle tout seul.
Autre chose qu’il vaut mieux découvrir maintenant que dans six mois : relancé sur le même texte, avec la même consigne, le modèle ne rend pas deux fois la même réponse. La seconde exécution a sorti un résumé formulé autrement, aussi juste. Ce n’est pas un bug, c’est le fonctionnement normal de la bête, et ça a une conséquence pratique : ne construis jamais un workflow qui suppose une sortie identique d’une fois sur l’autre.
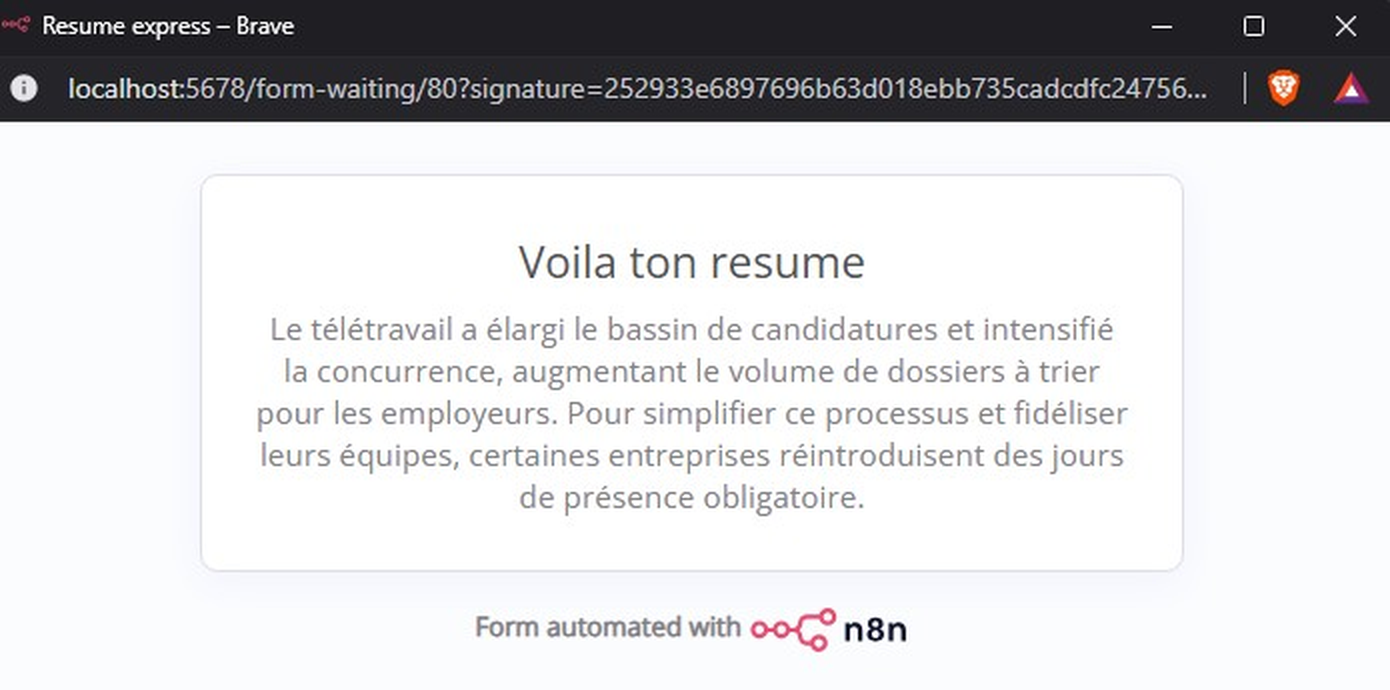
Le corollaire pratique : ne construis pas de workflow local où quelqu’un attend devant son écran. Construis-en pour ce qui tourne pendant que tu fais autre chose. Vingt secondes, c’est insupportable en direct et parfaitement indolore la nuit.
Là où ça coince encore
Le choix du modèle change tout, et pas dans le sens qu’on croit. J’ai llama3.1:8b installé aussi, et en français il invente. Pas des approximations : des faits entiers, avec aplomb. gemma4:12b sur la même consigne reste collé à la source. Prends le temps de tester deux ou trois modèles sur tes propres textes avant de bâtir quoi que ce soit dessus, et garde en tête que même le bon affirmera du faux avec assurance le jour où la question sortira de ce qu’il sait.
Un modèle trop gros pour ta mémoire ne plante pas, il rampe. Si ton résumé met trois minutes au lieu de vingt secondes, ce n’est pas n8n qui déraille, c’est le modèle qui déborde sur le disque. Descends d’une taille, la différence est spectaculaire.
La fenêtre de terminal doit rester ouverte. Tant que n8n tourne dans une fenêtre, fermer la fenêtre arrête tout, y compris ton joli formulaire. Pour un usage sérieux, il faudra en faire un service qui démarre avec la machine, mais c’est un autre chantier.
Le premier appel après l’allumage du PC est plus lent que les autres, parce que le modèle doit d’abord se charger en mémoire. Ne juge pas la vitesse sur le premier essai.
Et après ?
Ce qui rend ce petit montage intéressant, ce n’est pas le résumeur : c’est que le premier nœud est interchangeable. Remplace le formulaire par un déclencheur planifié et tu as un truc qui traite un dossier toutes les nuits. Remplace-le par un nœud de messagerie et tu as un trieur de mails. Le milieu, l’appel à l’IA locale, ne bouge pas d’un pouce.
C’est le moment où n8n devient réellement utile, et c’est aussi le moment où on commence à empiler les nœuds sans réfléchir. Mon conseil, pour ce qu’il vaut : garde un workflow par intention, et fais-le tourner une semaine avant d’en ajouter un deuxième.
Si tu bloques à une étape, les commentaires sont là. Et si tu trouves pourquoi le nœud de formulaire garde parfois une ancienne version en mémoire après une republication, je suis preneur, je n’ai pas compris.
Questions fréquentes
Faut-il Docker pour faire tourner n8n avec Ollama ?
Non. La plupart des guides passent par Docker parce qu’ils visent un serveur, mais sur une machine Windows personnelle, l’installation par npm suffit et évite la couche réseau supplémentaire, qui est justement celle qui casse les connexions vers Ollama.
Pourquoi n8n ne trouve pas Ollama alors qu’il tourne ?
Neuf fois sur dix parce que l’adresse est écrite localhost. Sur Windows, ce nom est résolu vers l’IPv6, où Ollama n’écoute pas. Écris http://127.0.0.1:11434.
Mon formulaire renvoie une erreur 404, pourquoi ?
Parce que le workflow n’est pas publié. Depuis n8n 2, il faut cliquer sur Publish : tant que ce n’est pas fait, les adresses de production des formulaires et des webhooks n’existent pas.
Est-ce que mes données partent quelque part ?
Non, si les deux outils tournent chez toi. n8n appelle Ollama sur ta propre machine et rien ne transite par internet. Attention quand même : le jour où tu ajoutes un nœud qui appelle un service en ligne, cette garantie tombe pour ce workflow.
Quel modèle choisir pour du français ?
Un modèle récent de taille moyenne fait mieux qu’un gros modèle ancien. Teste-les sur tes propres textes plutôt que de te fier aux classements : la seule mesure qui compte est celle sur ta machine, avec tes contenus.
Combien ça coûte ?
Rien. n8n en auto-hébergement et Ollama sont gratuits, les modèles aussi. Le seul coût est l’électricité et la place sur ton disque, entre 3 et 25 Go selon le modèle.