En France, la requête ramène deux pages sérieuses. Celle de Blent explique le principe et renvoie à des frameworks d’évaluation. Le cookbook de Hugging Face, traduit en français, montre comment construire un juge sur trente exemples et fait grimper sa corrélation avec des annotateurs humains de 0,567 à 0,843. Le conseil est le même des deux côtés, l’une le dit, l’autre le fait : avant de lui faire confiance, vérifie ton juge contre des humains.
Le conseil est bon. Ce qui manque, c’est la suite : des gens ont vérifié, depuis 2023, avec des centaines de milliers de jugements, et les résultats sont publics. Ils ne sont pas rassurants partout. J’ai ouvert les papiers. Regardons ce qu’ils mesurent.
L’essentiel : LLM as a judge, c’est quoi ?
« LLM as a judge » désigne l’usage d’un grand modèle de langage comme évaluateur : on lui donne une réponse produite par un autre modèle (ou par le même), des critères, un format de sortie, et il rend une note, un verdict ou une préférence entre deux candidats. La définition d’origine tient en une ligne du papier qui a fixé le terme, le 9 juin 2023 : « une façon scalable et explicable d’approcher les préférences humaines », Zheng et ses coauteurs, l’équipe derrière Chatbot Arena.
Concrètement, ça remplace deux choses. Les métriques de recouvrement de mots (BLEU, ROUGE), qui ne savent pas dire si une réponse est juste, seulement si elle ressemble à une référence. Et les annotateurs humains, qui savent, mais coûtent et ne passent pas à l’échelle. Le juge se déploie en trois formes : noter une réponse seule sur une échelle, comparer deux réponses et en préférer une, ou vérifier une réponse contre une référence fournie.
Le mot « juge » est bien choisi, et pas dans le sens flatteur. Un juge a des biais, on les mesure, et on peut le récuser. C’est exactement ce que la recherche fait depuis trois ans.
D’où vient le terme, et ce que vaut le « 80 % d’accord »
Le chiffre qui circule vient de ce papier de 2023 : GPT-4 juge est d’accord avec les humains « à plus de 80 % », soit le niveau d’accord des humains entre eux. Le chiffre est exact. Ce qu’il recouvre l’est moins.
Dans le tableau d’origine, l’accord de 85 % entre GPT-4 et les experts est mesuré sans les égalités : on ne garde que les cas où les deux ont tranché. En gardant tous les votes, le même accord tombe à 66 %, et l’accord entre humains à 63 %. Le hasard, lui, fait 50 % dans le premier cas et 33 % dans le second : le juge reste loin du tirage au sort, mais le chiffre rond cache que les deux mesures ne comptent pas la même chose. Et l’équipe le dit elle-même : l’accord monte de 70 % à près de 100 % à mesure que l’écart de qualité entre les deux modèles comparés grandit. Autrement dit, le juge est fiable quand la réponse est évidente. C’est précisément là où l’on a le moins besoin d’un juge.
Il y a une autre lecture, plus juste, de ce même papier : ses auteurs n’ont pas vendu le juge, ils l’ont mis à l’épreuve. Quatre limites y sont nommées dès le résumé et mesurées dans le corps du papier. Trois ans plus tard, on sait ce qu’elles sont devenues.
Trois biais mesurés dès 2023
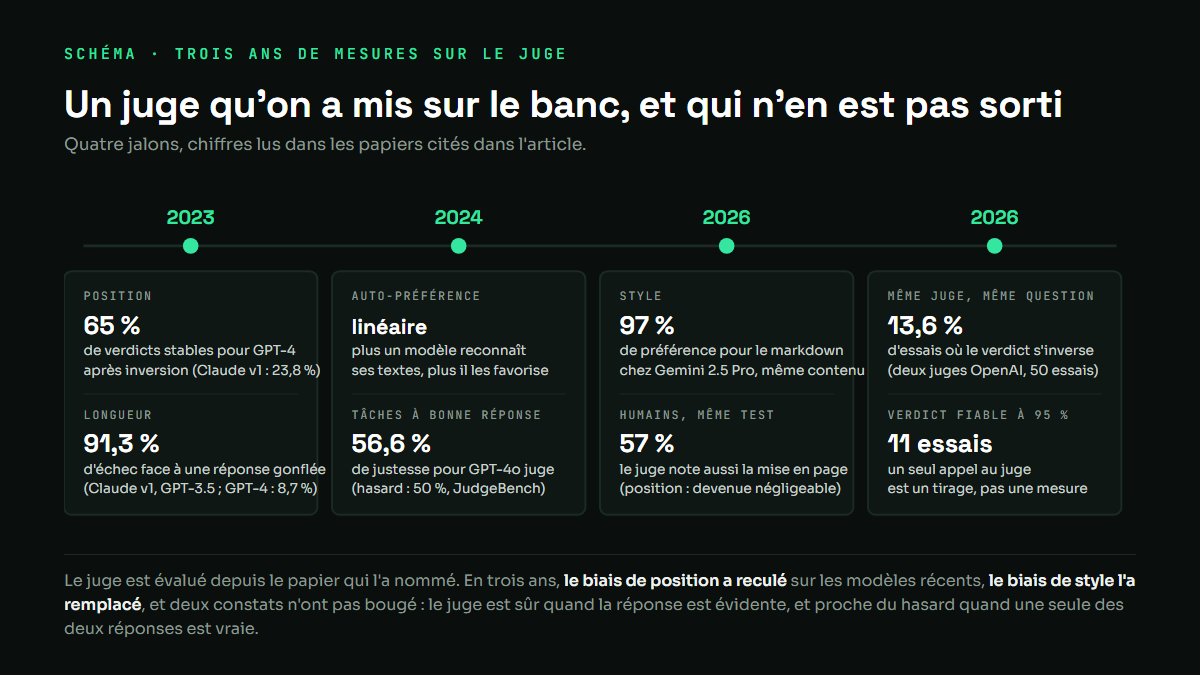
La position. Quand on présente au juge deux réponses très proches puis qu’on inverse leur ordre, GPT-4 rend le même verdict dans 65 % des cas seulement. Claude v1, à l’époque, dans 23,8 % des cas, avec une préférence pour la première réponse dans 75 % des paires. Une équipe de Pékin l’avait montré onze jours plus tôt, le 29 mai 2023, avec un titre sans nuance, « Les grands modèles de langage ne sont pas des évaluateurs équitables » : en jouant sur l’ordre d’apparition, Vicuna-13B bat ChatGPT sur 66 des 80 questions testées, avec ChatGPT lui-même pour arbitre.
La longueur. Le test de 2023 est simple : on prend une bonne réponse, on lui ajoute une liste qui répète ce qui est déjà dit, et on demande au juge laquelle est la meilleure. Claude v1 et GPT-3.5 préfèrent la version gonflée dans 91,3 % des cas. GPT-4 dans 8,7 %. Le biais est réel, et il est apprivoisable : en avril 2024, l’équipe d’AlpacaEval a montré qu’en contrôlant statistiquement la longueur, la corrélation de son classement avec Chatbot Arena passe de 0,94 à 0,98.
L’auto-préférence. Un modèle qui juge ses propres réponses les note-t-il mieux ? En 2023, l’équipe de Zheng voit GPT-4 se donner 10 points de taux de victoire en plus, et Claude v1 25, mais elle écrit ne pas pouvoir conclure, faute de données. La réponse arrive le 15 avril 2024, de Panickssery, Bowman et Feng : les modèles reconnaissent leurs propres textes, et plus un modèle est capable de reconnaître sa production, plus il la favorise. La relation est linéaire, et les auteurs la tiennent pour causale : leurs expériences contrôlées écartent les facteurs de confusion les plus simples. La doc d’Anthropic, dans son guide d’évaluation, pose la même règle en commentaire de code : « il est généralement préférable d’utiliser un modèle différent pour évaluer que celui qui a produit la sortie évaluée ».
| Ce qui est mesuré | Étude, date | Résultat |
|---|---|---|
| Accord GPT-4 / humains experts | Zheng et al., 09/06/2023 | 85 % sans les égalités, 66 % avec ; humains entre eux : 81 % et 63 % |
| Biais de position | Zheng et al., 09/06/2023 | verdict inchangé après inversion : GPT-4 65 %, GPT-3.5 46,2 %, Claude v1 23,8 % |
| Ordre manipulé | Wang et al., 29/05/2023 | Vicuna-13B bat ChatGPT sur 66 questions sur 80, ChatGPT juge |
| Biais de longueur (liste répétitive) | Zheng et al., 09/06/2023 | Claude v1 et GPT-3.5 trompés à 91,3 %, GPT-4 à 8,7 % |
| Auto-préférence | Panickssery et al., 15/04/2024 | corrélation linéaire entre auto-reconnaissance et auto-préférence, tenue pour causale après contrôles |
| Justesse sur tâches à bonne réponse | JudgeBench, Tan et al., 16/10/2024 | GPT-4o 56,6 % (hasard : 50 %), Claude 3.5 Sonnet 64,3 %, o1-preview 75,4 % |
| Stabilité d’un même juge, même question | Yagubyan, 23/04/2026 | verdict inversé dans 13,6 % des essais en moyenne, 28 % des questions au-dessus de 20 % |
| Biais de style (markdown contre prose) | Soumik, 25/04/2026 | 0,10 à 0,76 selon le juge ; position ≤ 0,04 sur les mêmes modèles |
Ce que 2026 a changé : la position recule, le style prend la place
Les modèles de 2023 sont morts. Les biais, eux, ont été remesurés sur ceux de 2025 et 2026, et le classement a changé. Le 25 avril 2026, une étude compare neuf stratégies de correction sur cinq juges (Gemini 2.5 Pro et Flash, Claude Sonnet 4, GPT-4o, Llama 3.3). Le biais de position, celui de 2023, y est devenu « négligeable (≤ 0,04 sur les cinq modèles) ». À sa place, un biais que presque personne ne mesurait : le style. Face à deux réponses de même contenu, l’une en markdown, l’autre en prose, Gemini 2.5 Pro préfère le markdown dans 97 % des cas, Claude Sonnet 4 dans 83 %. Les deux annotateurs humains de l’étude, l’auteur et un volontaire, sur trente paires : 57 %. Le juge ne note pas seulement ce que tu dis, il note aussi comment c’est mis en page.
Le biais de longueur, lui, n’est plus une règle : Llama et les deux Gemini préfèrent encore le plus long, GPT-4o est neutre, et Claude Sonnet 4 préfère le plus court. Le même correctif ne vaut donc pas pour tous les juges, ce que l’auteur reconnaît comme un problème ouvert.
Deux autres travaux du printemps 2026 attaquent une question plus gênante : un même juge, sur une même question, rend-il le même verdict ? Le 23 avril, un chercheur, seul signataire, fait rejuger 29 tâches cinquante fois chacune par GPT-4o-mini et GPT-4.1-mini. La préférence entre deux réponses s’inverse en moyenne dans 13,6 % des essais, et sur 28 % des questions, dans plus d’un essai sur cinq. Pour retrouver, avec 95 % de chances, le verdict qu’on obtiendrait en votant cinquante fois, il faut onze essais en moyenne, quinze sur les questions les plus instables. Sur ces deux modèles au moins, un seul appel au juge est un tirage, pas une mesure.
Le 17 juin 2026, ce que ses auteurs présentent comme la plus grande évaluation à ce jour, 21 juges de neuf fournisseurs et environ 541 000 jugements, ajoute le point qui devrait figurer dans toutes les fiches. Deux juges déployés en production y montrent une répétabilité supérieure à 0,95 et un biais de position supérieur à 0,10. Les auteurs appellent ça le paradoxe cohérence-biais, et leur titre dit le reste : « fiabilité sans validité ». Un juge qui rend toujours le même verdict n’est pas pour autant un juge qui rend le bon. L’un de ces deux juges est Gemini 2.5 Flash, celui que l’étude d’avril donnait pour quasi insensible à la position : deux protocoles, deux verdicts sur le même modèle, et aucun des deux papiers ne cite l’autre. Le classement des 21 juges bouge de jusqu’à 14 places selon le banc d’essai utilisé.
Le point que les pages françaises ne disent pas : le juge est bon là où on n’en a pas besoin
L’essentiel de ce qui précède mesure l’accord du juge avec des préférences humaines. Sur une réponse de chatbot, la préférence est la seule vérité disponible. Mais une part croissante de ce qu’on demande aux modèles a une bonne réponse : un calcul, un code qui passe les tests, un fait. Que vaut le juge là-dessus ?
Une équipe de Berkeley a posé la question en octobre 2024 avec JudgeBench : 350 paires de réponses où l’une est objectivement correcte et l’autre non, en connaissances, raisonnement, maths et code. Les réponses sont construites pour être plausibles toutes les deux. Résultat : GPT-4o juge à 56,6 % de justesse, là où le hasard fait 50 %. Sur les questions de connaissances, 50,65 %. Claude 3.5 Sonnet monte à 64,3 %, o1-preview à 75,4 %, et la mise à jour du banc en avril 2025 ajoute o3-mini à 80,9 %. Les modèles de raisonnement sont ceux qui s’éloignent le plus de la pièce jetée en l’air. Les modèles de récompense spécialisés, entraînés pour ça, plafonnent au niveau de Claude.
Ce résultat rejoint celui de 2023 par l’autre bout. L’accord avec les humains grimpe quand l’écart de qualité est évident ; la justesse retombe vers le hasard quand les deux réponses sont bien écrites et qu’une seule est vraie. Le juge mesure surtout ce qui se voit. Un modèle qui se trompe avec assurance produit une réponse plausible, et une hallucination bien tournée passe le juge comme elle passe le lecteur.
L’équipe de 2023 avait trouvé une parade sur les maths, et elle est plus curieuse qu’il n’y paraît : faire d’abord résoudre le problème par le juge, puis lui montrer sa propre réponse comme référence au moment de noter. Son taux d’erreur passe de 14 sur 20 à 3 sur 20. Le juge note donc bien mieux quand il a une réponse sous les yeux, même la sienne. Avec une vraie référence, écrite par un humain, on peut attendre au moins autant, mais cette mesure-là n’est pas dans le papier. Il faut le reconnaître : ce n’est pas un défaut de tel ou tel modèle, c’est la place exacte de l’outil. Il compare mieux qu’il ne découvre.
Ce que ça établit, et ce que ça n’établit pas
Ce que ça établit : sur des préférences, un juge de premier rang est aussi d’accord avec la majorité des humains que les humains entre eux, et depuis 2023 on sait corriger une partie de ses biais. Inverser l’ordre des réponses et ne garder que les verdicts stables, faire écrire au juge son raisonnement avant sa note (chaîne de pensée) : ces deux-là ont un gain chiffré dans les études citées. Voter plusieurs fois et prendre un modèle différent de celui qu’on évalue n’ont pas de gain mesuré, seulement le biais mesuré en face d’eux. L’étude d’avril 2026 arrive même à 71 % d’accord avec un modèle de milieu de gamme, à un millième de dollar l’évaluation.
Ce que ça n’établit pas : qu’un juge sache reconnaître une réponse fausse mais bien écrite. Sur ce terrain, les chiffres disponibles vont de 50 à 81 % selon le juge, et les meilleurs sont des modèles de raisonnement. Ni qu’un juge validé une fois reste validé : les biais ont changé de nature entre 2023 et 2026, et le classement des juges dépend du banc d’essai. Deux réserves que je n’ai pas pu lever : les études de 2026 sur la stabilité et sur le style sont chacune d’un auteur unique, sans réplication à ma connaissance, et sur le biais de position elles se contredisent. Un juge se vérifie contre des humains, sur tes données, et tu recommences quand le modèle change.
Les questions qui reviennent
LLM as a judge, ça se traduit comment ?
« Modèle juge » ou « évaluation par LLM » selon les sources ; on croise aussi « LLM évaluateur ». Aucun terme français ne s’est imposé, et la doc technique garde l’anglais, souvent avec des tirets : LLM-as-a-Judge.
Quel modèle prendre comme juge ?
Pas celui que tu évalues : c’est la règle que la doc d’Anthropic pose et que la mesure de 2024 sur l’auto-préférence justifie. Pour le reste, l’étude d’avril 2026 trouve qu’un modèle de milieu de gamme bien corrigé (Gemini 2.5 Flash, avec inversion d’ordre, raisonnement écrit et grille de critères) fait aussi bien qu’un modèle de premier rang pour quinze fois moins cher, et celle de juin trouve à ce même modèle un biais de position marqué. Si la tâche a une bonne réponse, JudgeBench montre que les modèles de raisonnement sont ceux qui s’écartent le plus du hasard.
Faut-il une réponse de référence ?
Quand elle existe, oui : la seule mesure disponible, celle de 2023, montre un juge qui divise son taux d’erreur par plus de quatre dès qu’il a une réponse sous les yeux, et c’était la sienne. Quand elle n’existe pas, le juge évalue une préférence, et il faut lire ses scores comme tels. Le cookbook de Hugging Face montre la bonne méthode pour ce cas : une échelle courte à quatre niveaux, une justification écrite avant la note, et une corrélation vérifiée contre des humains sur un échantillon.
À retenir
- LLM as a judge, c’est faire noter une réponse d’IA par un modèle de langage, seule, face à une autre, ou contre une référence. Terme fixé le 9 juin 2023 par l’équipe de Chatbot Arena.
- Le « 80 % d’accord avec les humains » est mesuré sans les égalités (66 % avec) et monte avec l’écart de qualité : le juge est sûr quand la réponse est évidente.
- Trois biais chiffrés dès 2023 : position (GPT-4 stable à 65 % après inversion), longueur (91,3 % d’échec pour Claude v1 et GPT-3.5), auto-préférence (relation linéaire mesurée en 2024).
- En 2026, la position est devenue négligeable et le style domine : markdown préféré à 97 % par Gemini 2.5 Pro contre 57 % chez les humains. Deux juges de gamme mini inversent leur verdict dans 13,6 % des essais.
- Le point aveugle des fiches françaises : sur des réponses dont une seule est vraie, GPT-4o juge à 56,6 %, le hasard à 50 % (JudgeBench, 2024).