Ce qui change le 14 août, et pour qui exactement
Jusqu’ici, Claude Code fonctionnait sur un principe simple : l’agent propose, tu valides. Chaque commande shell, chaque écriture de fichier passait par une demande d’autorisation que tu acceptais ou refusais. À partir du 14 août 2026, ce n’est plus le réglage par défaut. Les nouvelles sessions ouvertes sur les formules Pro, Max et Team démarrent en mode auto, où un classifieur distinct examine chaque appel d’outil à ta place et ne t’interrompt que s’il bloque quelque chose.
Le périmètre est précis, et il vaut la peine de le lire avant de s’énerver. Les comptes Claude Enterprise, l’API, ainsi que les déploiements sur Amazon Bedrock, Google Cloud Agent Platform et Microsoft Foundry restent en opt-in, avec une bascule annoncée « dans le mois qui vient » (Anthropic, billet du 7 août 2026). Si tu avais déjà choisi un mode toi-même, il reste en place : tu recevras une proposition ponctuelle de bascule, à accepter ou non. Et si ton organisation a figé un mode via les réglages administrés, rien ne bouge.
Ce n’est donc pas le fameux --dangerously-skip-permissions, celui que tout le monde appelle le mode yolo et qui, lui, ne vérifie rien du tout. Le mode auto se place entre les deux : il ne demande plus, mais il continue de filtrer. La nuance est réelle. Elle mérite quand même qu’on regarde sur quoi elle s’appuie.
Le chiffre que tout le monde recopie : 89 % contre 13,6 %
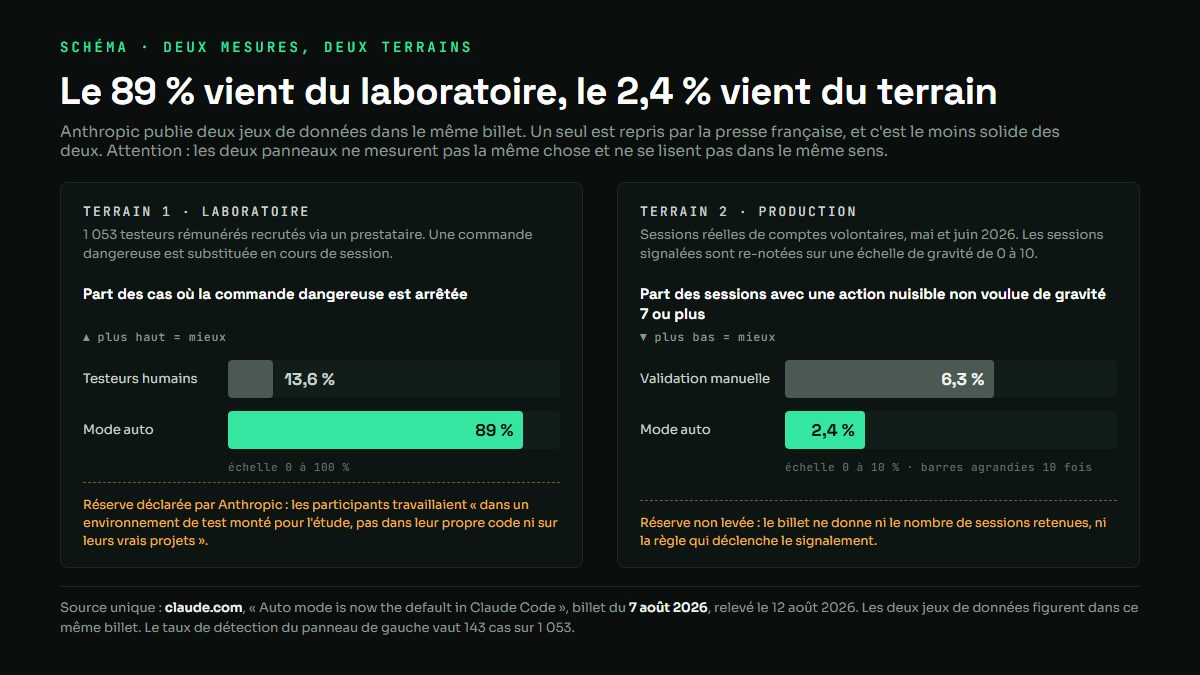
Depuis l’annonce, la couverture française tourne autour d’un seul résultat. Anthropic a recruté 1 053 testeurs rémunérés via un prestataire de recherche, leur a fait faire une tâche de développement, et a substitué en cours de session une commande dangereuse. Les testeurs l’ont repérée 143 fois sur 1 053, soit 13,6 %. Le mode auto, lui, l’a bloquée dans 89 % des cas.
Le raccourci s’écrit tout seul : la machine surveille mieux que l’humain, six fois mieux. C’est le chiffre qu’a repris le Blog du Modérateur le 10 août, comme la plupart des articles parus cette semaine, et il est exact. Je l’ai vérifié à la source, il est bien dans le billet d’Anthropic, avec son effectif et son détail.
Ce qui manque partout, c’est la phrase qui suit.
Ce que cette étude ne pouvait pas mesurer
Anthropic écrit noir sur blanc, dans le même billet, les limites de son protocole : « These participants worked in a test environment set up specifically for the study, not in their own codebases or on real projects. » Des participants qui travaillaient dans un environnement de test monté pour l’occasion, pas dans leur propre code ni sur de vrais projets.
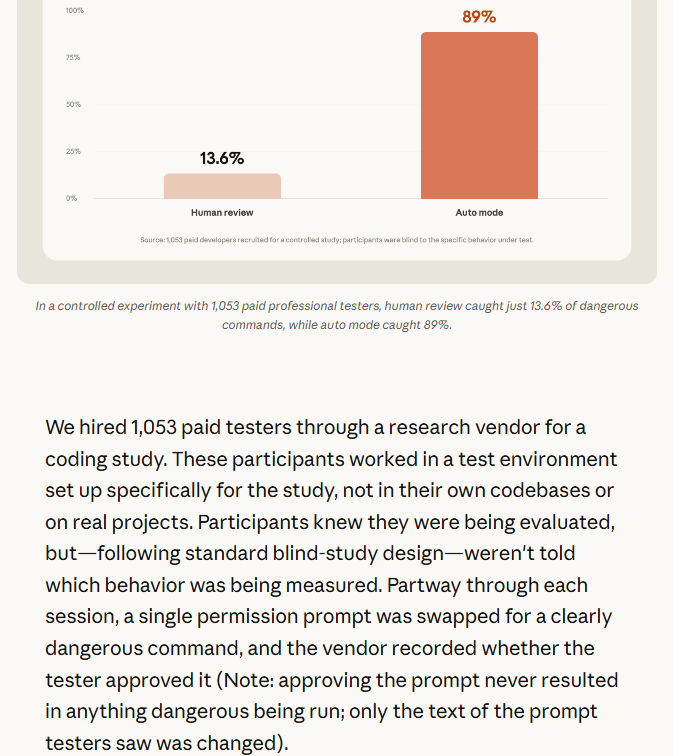
Un point d’abord, parce qu’il joue en faveur de l’étude et qu’il serait malhonnête de le sauter : les testeurs savaient qu’on les évaluait, mais ils ignoraient quel comportement était mesuré, ce qui est la construction en aveugle habituelle. Le dispositif n’a rien d’amateur.
C’est l’enjeu qui manque, pas la rigueur. Un développeur payé pour une session d’essai, dans un dépôt qui n’est pas le sien, sur un projet dont il se moque, n’a rien à perdre si une commande efface quelque chose. Anthropic précise d’ailleurs que rien de dangereux n’était réellement exécuté : seul le texte du message affiché au testeur était remplacé. Trois raisons cumulées de ne pas avoir peur, et la peur est précisément ce qui déclenche la vigilance. Celle que tu as devant ton propre dépôt de production, un vendredi soir, n’a rien à voir. Les 13,6 % mesurent l’attention de quelqu’un qui ne risque rien, ce qui donne un plancher, pas une moyenne.
Ça ne rend pas l’étude malhonnête, au contraire : c’est Anthropic qui pose la réserve, personne ne l’a débusquée. Mais un benchmark publié par le vendeur, sur un dispositif construit par lui, dans des conditions qu’il reconnaît lui-même comme artificielles, ça reste un argument. Pas une preuve.
La mesure que personne ne cite, et elle est meilleure
Le plus étrange dans cette séquence, c’est que le billet contient un second jeu de données, et qu’il est nettement plus solide que le premier. Il n’apparaît nulle part dans la couverture française que j’ai lue.
Sur mai et juin 2026, Anthropic a repris des sessions réelles de comptes volontaires, isolé celles qui avaient été signalées, puis les a fait re-noter sur une échelle de gravité de 0 à 10. Résultat : les sessions passées en validation manuelle contenaient une action nuisible non voulue de gravité 7 ou plus dans 6,3 % des cas, contre 2,4 % pour les sessions en mode auto. Plus de deux fois moins.
Là, on parle de vrais dépôts, de vrai code, de gens qui avaient quelque chose à perdre. C’est exactement ce que l’étude en laboratoire ne pouvait pas atteindre. Et il faut le reconnaître, puisque c’est le fond du sujet : sur ce terrain-là, l’annonce tient. Le mode auto ne fait pas seulement mieux qu’un testeur désintéressé, il fait mieux que des utilisateurs en conditions réelles.
Reste la question de l’échantillon, qui n’est pas donnée. « Les sessions signalées » sur deux mois, chez des comptes qui ont accepté le partage, ça peut vouloir dire beaucoup de choses, et le billet ne dit ni combien de sessions ni comment le signalement se déclenche. Le chiffre est meilleur que l’autre. Il n’est pas indépendant pour autant.
Le vrai chiffre du problème : 97 % d’approbations
Il y a une donnée qui explique toute cette bascule, et ce n’est aucune des précédentes. Selon Anthropic, les utilisateurs de Claude Code approuvent 97 % des demandes de permission qui leur sont présentées. Quatre-vingt-dix-sept.
Un garde-fou qu’on franchit dans 97 % des cas n’est plus un garde-fou, c’est une formalité. Le geste de validation avait cessé d’être une décision bien avant qu’Anthropic ne le retire : il était devenu un réflexe, la case cookies qu’on accepte sans lire. Vu sous cet angle, l’entreprise ne te retire pas un pouvoir de contrôle. Elle constate qu’il ne s’exerçait plus.
Le contraste avec un autre chiffre du billet achève de le démontrer. Quand Claude présente un plan à valider, et non une commande isolée, les utilisateurs en rejettent 39 %. Face à une intention lisible, les gens lisent et refusent. Face au trois-centième appel d’outil de la session, ils cliquent. Ce n’est pas un problème de vigilance individuelle, c’est un problème de format : on ne relit pas trois cents fois par jour.
Ce que le classifieur refuse par principe, et ce qui n’a aucun chiffre
Sur le fonctionnement, la documentation est claire. Le classifieur vise les actions irréversibles, destructrices, ou dirigées hors de ton environnement. Certaines catégories sont en refus dur : l’exfiltration de données, c’est-à-dire l’envoi de ton code ou de tes secrets vers l’extérieur, appartient d’après Anthropic à un ensemble que le classifieur n’approuve jamais. S’ajoute une sonde côté API qui inspecte les contenus que Claude va chercher lui-même, pages web, fichiers, sorties d’outils, pour y détecter des tentatives de détournement de son comportement. C’est la protection contre l’injection de prompt, ce moment où un texte lu par l’agent contient des instructions qui lui sont adressées.
Ces deux mécanismes n’ont aucun chiffre attaché. Pas de taux de détection, pas de faux positifs, pas de méthode. Ce sont des principes de conception présentés comme tels, et je ne vois pas comment les évaluer depuis l’extérieur. À ce stade, c’est une affirmation, pas un résultat.
Le garde-fou opérationnel, lui, est documenté : après trois blocages consécutifs, ou vingt cumulés dans une même session, Claude Code repasse en validation manuelle. Autrement dit, le système considère qu’une session qui se fait bloquer en boucle a déraillé et te rend la main. C’est une bonne idée, et elle avoue quelque chose au passage : le classifieur peut se tromper assez souvent pour qu’il ait fallu prévoir la sortie de secours.
Quatre entreprises citées, un seul chiffre
Le billet s’appuie aussi sur des clients, et c’est la partie la plus faible du dossier. Adobe raconte que Claude construit l’interface puis vérifie seul qu’elle correspond à l’intention avant qu’un humain ne regarde. Chez Nuro, quelqu’un décrit un agent lancé à 22 heures qui tournait encore à 5 heures du matin et a rendu trois pull requests. Garner Health a poussé le mode auto par défaut à ses 550 employés via les réglages administrés.
Ce sont des récits. Ils disent que des équipes sérieuses ont adopté le mode auto, ce qui est une information, mais aucun ne mesure quoi que ce soit. Une nuit de 22 heures à 5 heures produit trois pull requests, très bien : personne ne dit ce qu’elles valaient, ni combien ont été fusionnées.
Un seul témoignage porte un chiffre exploitable, et c’est celui de Gusto : environ 10 % des sessions depuis la mi-mai contiennent un refus du classifieur. Celui-là m’intéresse, parce qu’il donne enfin un ordre de grandeur de la fréquence d’intervention. Un blocage toutes les dix sessions, ce n’est ni du théâtre ni de l’obstruction permanente. C’est le seul point du billet où l’on voit le système travailler dans la durée chez un tiers.
Ce que tu fais le 14 août, concrètement
Si tu ne veux pas du mode auto, le changement se fait à la volée : Shift+Tab dans le terminal fait tourner les modes de permission, et l’application de bureau propose le même choix dans un menu. Rien n’est verrouillé, et tu peux changer en cours de session. Côté équipe, un administrateur peut fixer le mode par défaut de l’organisation avec defaultMode dans les réglages administrés, ou interdire complètement le mode auto avec disableAutoMode.
Si tu le gardes, la recommandation à retenir vient d’Anthropic lui-même, et elle est plus prudente que le reste du billet : sur les changements à fort enjeu touchant une infrastructure de production, l’entreprise conseille de continuer à relire les actions de Claude toi-même. Ce qui revient à dire que le mode auto est conçu pour le travail courant, pas pour le moment où ça compte vraiment.
Ma lecture, pour ce qu’elle vaut : la bascule est défendable, et les données de production la défendent mieux que l’étude qu’on recopie partout. Ce qui me gêne n’est pas le classifieur, c’est le glissement de responsabilité qu’il installe. Tant que tu cliquais, l’erreur était la tienne. Maintenant, elle appartient à un modèle dont personne d’extérieur n’a pu mesurer la fiabilité. Il faudra un jour un benchmark qui ne soit pas publié par le vendeur.
En attendant, si tu découvres Claude Code avec cette annonce, la procédure d’installation sur Windows n’a pas bougé, et le mécanisme général de ces outils est expliqué dans notre fiche sur ce qu’est un agent IA. Pour le reste du mouvement en cours, GitHub a ouvert sa propre plateforme aux agents concurrents, un sujet que nous avons traité dans le décryptage consacré à Agent HQ. Quant au geste de valider sans lire, il porte un nom depuis février 2025, et un périmètre beaucoup plus étroit que ce qu’on lui prête : le vibe coding. Et si tu veux un garde-fou qui ne dépende pas du jugement du classifieur, un hook avec le code de sortie 2 bloque une commande même en mode auto.