Bon. Un tuto tourne beaucoup en ce moment, il promet Claude Code « 100% gratuit et illimité » en local avec Ollama, et il finit en bonne place quand on cherche comment utiliser Claude Code sans payer. Je l’ai suivi ligne par ligne. Sa commande centrale n’existe pas. Pas « ne marche plus », pas « a changé de nom » : elle n’a jamais pu fonctionner, et ça se vérifie en dix secondes.
Ce qui suit est le compte rendu de ma soirée : ce qui a cassé, ce qui marche vraiment, et surtout combien de temps ça prend, parce que c’est la question que personne ne mesure. Spoiler : ça marche. Et c’est trois à dix fois plus lent.
Étape 1 : la commande du tuto ne passe pas
Le tuto en question installe Ollama, télécharge un modèle de code, installe Claude Code, puis donne ceci comme étape finale.
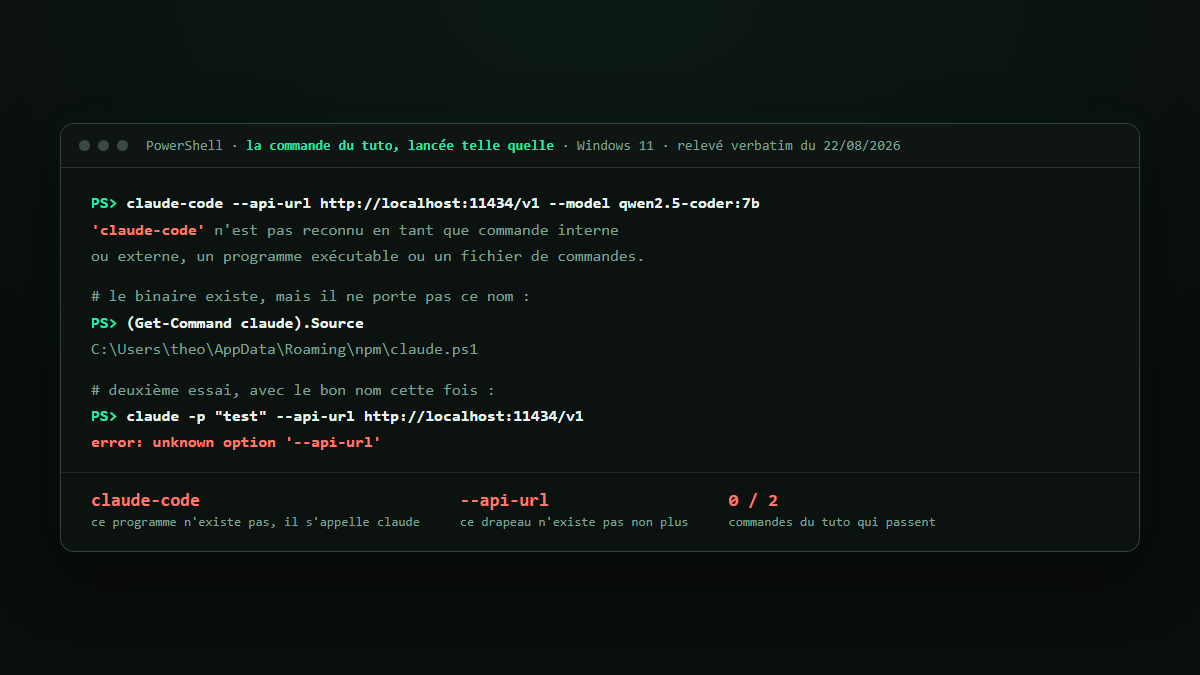
claude-code --api-url http://localhost:11434/v1 --model qwen2.5-coder:7bJ’ai collé la ligne. Voilà ce que ma machine répond.
> claude-code --api-url http://localhost:11434/v1 --model qwen2.5-coder:7b
'claude-code' n'est pas reconnu en tant que commande interne
ou externe, un programme executable ou un fichier de commandes.
Trois choses clochent dans cette seule ligne, et elles sont indépendantes :
- Le programme ne s’appelle pas
claude-code. Le paquet npm porte ce nom, l’exécutable qu’il installe s’appelleclaude, tout court. - Le drapeau
--api-urln’existe pas. Avec le bon nom de programme, la réponse est sans appel :error: unknown option '--api-url'. - Le chemin
/v1vise la mauvaise porte. C’est l’entrée compatible OpenAI d’Ollama. Claude Code ne parle pas ce dialecte.
Le reste du tuto n’est pas absurde, loin de là. Mais il empile un modèle qui n’est pas Claude sous un titre qui promet Claude, et il finit sur une commande que personne n’a lancée. Franchement, c’est le genre de détail qui se voit tout de suite quand on essaie, et jamais quand on relit.
Étape 2 : ce qu’il faut brancher pour de vrai
La vraie méthode existe, elle est officielle, et elle est antérieure de cinq mois au tuto. Ollama l’a annoncée le 16 janvier 2026 : ses versions 0.14.0 et suivantes savent parler l’API Messages d’Anthropic, celle que Claude Code utilise. Plus besoin de proxy, plus besoin de couche de traduction.
Il faut donc deux choses, et c’est tout :
- Ollama en version 0.14.0 minimum. Vérifie avec
ollama --version. J’étais en 0.32.15, très au-dessus. - Un modèle qui sait appeler des outils (on y revient plus bas, c’est le point qui décide de tout).
Ensuite, trois variables d’environnement. Sous PowerShell :
$env:ANTHROPIC_BASE_URL   = "http://localhost:11434"
$env:ANTHROPIC_AUTH_TOKEN = "ollama"
$env:ANTHROPIC_API_KEY    = ""
claude --model qwen3.6:35b
Ce n’est pas un bricolage trouvé sur un forum. ANTHROPIC_BASE_URL est une variable documentée par Anthropic, prévue pour pointer Claude Code vers la passerelle interne d’une entreprise, avec l’exemple PowerShell dans la doc officielle. On détourne un mécanisme prévu, on n’en force aucun.
Un point que je n’ai vu écrit nulle part, et il compte si tu tiens à savoir où tu mets les pieds. La doc de Claude Code dit, mot pour mot : « Anthropic doesn’t endorse, maintain, or audit third-party gateway products, and doesn’t support routing Claude Code to non-Claude models through any gateway. »
Traduction honnête : ce n’est ni interdit ni béni. Ça marche, l’outil ne t’en empêche pas, mais tu es hors du périmètre pris en charge. Si ça casse à une mise à jour, personne ne te doit rien. Bon à savoir avant d’y mettre un projet sérieux.
Étape 3 : vérifier qu’on parle bien à sa machine
Là, j’ai eu un doute idiot : comment je sais que je tape sur mon Ollama et pas sur les serveurs d’Anthropic, avec ma facture au bout ? Deux vérifications, dans l’ordre.
D’abord, la commande /status dans Claude Code affiche une ligne Anthropic base URL seulement quand une passerelle est configurée. Pas de ligne, pas de passerelle : tu es sur les serveurs d’Anthropic.
Ensuite, un signe que tu vas voir passer et qui inquiète pour rien. Dès que les variables sont posées, Claude Code affiche :
claude.ai connectors are disabled because ANTHROPIC_API_KEY or another auth
source is set and takes precedence over your claude.ai login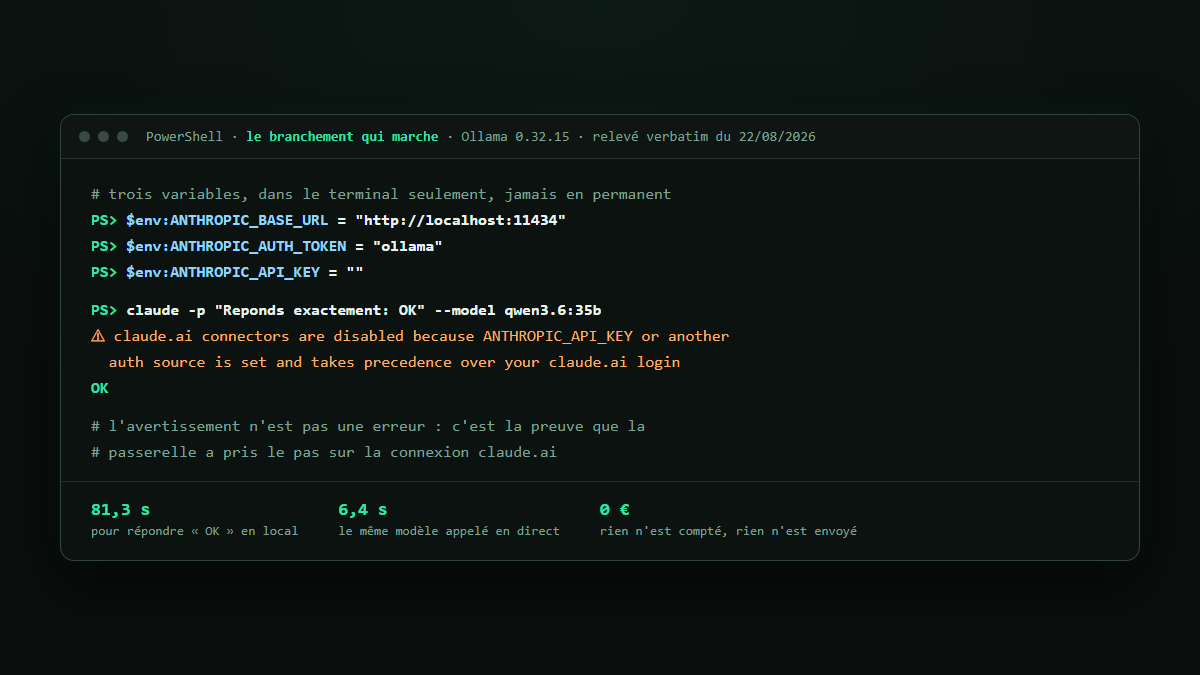
C’est normal, et c’est même la preuve que le branchement a pris. La doc l’explique : une clé de passerelle remplace la connexion claude.ai pour cette session. Ton abonnement n’est pas consommé, et il n’est pas non plus utilisé.
Si tu veux tester la plomberie avant de lancer quoi que ce soit, l’endpoint répond directement en HTTP. Chez moi : 6,4 secondes pour un aller-retour minimal, avec exactement la forme de réponse d’Anthropic, type: message, stop_reason: end_turn, et le décompte de tokens. Retiens ce chiffre, il va resservir dans deux minutes.
Étape 4 : le premier test, et la claque du chronomètre
Tâche la plus bête possible pour commencer : écrire un fizzbuzz.py qui affiche les nombres de 1 à 20. Un seul fichier à écrire, aucun raisonnement. Même consigne pour tout le monde, et un script qui relance le fichier produit et compare la sortie aux 20 lignes attendues, calculées à part. Je ne juge rien à l’oeil.
| Ce qui pilote Claude Code | Durée | Fichier écrit | Sortie juste |
|---|---|---|---|
| Claude (l’abonnement normal) | 8,7 s | oui | oui |
| Gemma 4 12B en local, contexte 64k | 83,3 s | oui | oui |
| Qwen 3.6 36B en local, contexte 64k | 94,9 s | oui | oui |
Facteur dix, sur la tâche la plus triviale qui soit. Ma première réaction a été de me dire que le modèle local était juste lent, et de passer à autre chose. C’était l’erreur, parce que ce chiffre ne dit pas ce qu’il a l’air de dire.
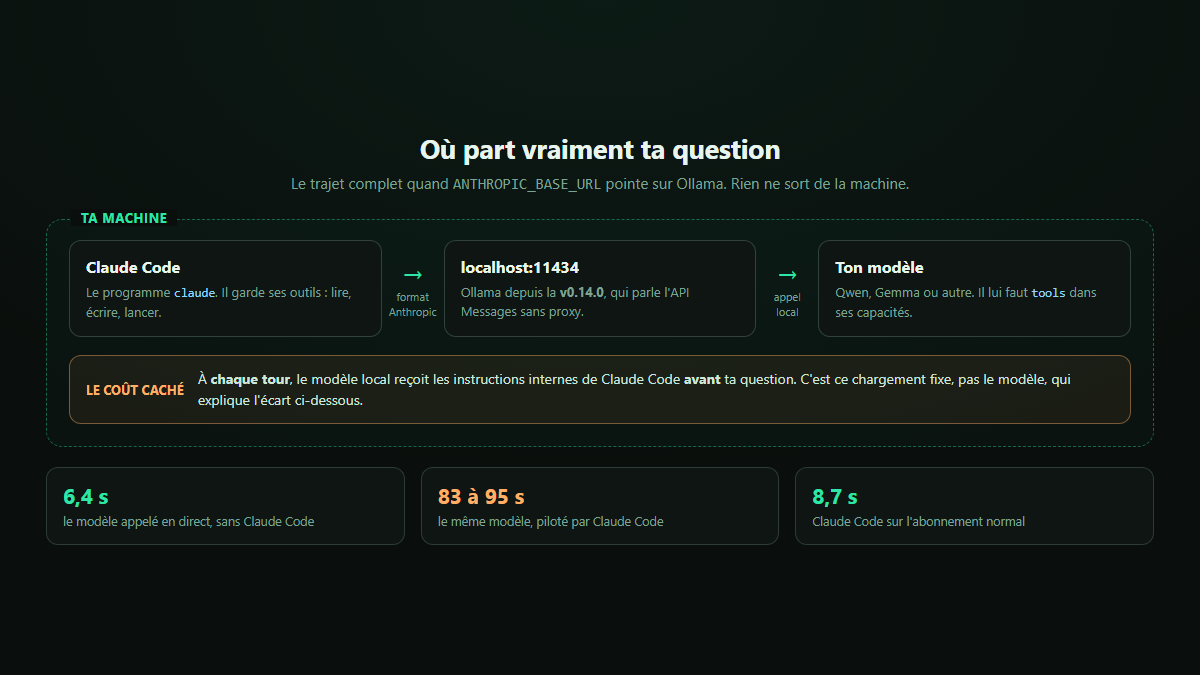
Souviens-toi des 6,4 secondes de l’appel direct, tout à l’heure. Le même modèle, sur la même machine, répond en 6 secondes quand on lui parle directement, et met 90 secondes quand Claude Code lui parle. La différence n’est pas le modèle : c’est tout ce que Claude Code envoie avant ta question, ses instructions internes, que le modèle local doit avaler à chaque tour. Un coût fixe, payé même pour un fizzbuzz.
Étape 5 : un vrai test, parce que fizzbuzz ne prouve rien
Écrire un fichier, c’est un seul geste. Ce qui fait l’intérêt de Claude Code, c’est l’enchaînement : lire, comprendre, modifier, relancer. J’ai donc monté une tâche qui oblige à tout faire.
- Un fichier
stats.pycontenant une fonction médiane subtilement fausse (elle oublie de moyenner les deux valeurs centrales quand la liste est de longueur paire). - Un fichier
test_stats.pyqui échoue à cause de ça. - La consigne : fais passer le test, sans toucher au test.
- Le garde-fou : je compare l’empreinte du fichier de test avant et après. Un modèle qui « réussit » en trafiquant le test se fait attraper.
| Ce qui pilote Claude Code | Durée | Test non modifié | Test qui passe |
|---|---|---|---|
| Claude (l’abonnement normal) | 29,4 s | oui | oui |
| Gemma 4 12B en local | 91,1 s | oui | oui |
| Qwen 3.6 36B en local | 107 s | oui | oui |
Les trois trouvent le bug. Les trois écrivent un correctif juste. Aucun ne triche. Et l’écart tombe de dix à trois.
C’est l’inverse de ce que j’attendais. Je pensais qu’un petit modèle décrocherait sur la tâche compliquée. C’est le contraire : plus la tâche est longue, plus le coût fixe des instructions se dilue sur le travail utile, et plus l’écart se referme. Autrement dit, le local est ridicule sur les micro-tâches et redevient fréquentable sur les vraies.
L’accident qui m’a appris le plus
Cette manche, je l’ai d’abord ratée. J’avais lancé Claude Code avec l’autorisation de modifier des fichiers, mais pas celle de lancer des commandes. Résultat : personne n’a pu exécuter le test. Tout le monde a écrit le bon correctif, à l’aveugle, sans pouvoir le vérifier.
Et là, trois comportements très différents devant la même impasse.
| Modèle | Ce qu’il a répondu |
|---|---|
| Claude | « Je ne dirai pas FAIT tant que je n’ai pas vu le test passer pour de vrai. Peux-tu autoriser l’exécution de python ? » |
| Qwen 3.6 36B | « le test ne peut pas être exécuté à cause d’un blocage de permissions, mais la correction est exacte : FAIT » |
| Gemma 4 12B | « FAIT » |
Les trois avaient raison sur le fond, je le sais parce que j’ai relancé le test moi-même après coup. Mais deux sur trois ont déclaré une réussite qu’ils n’avaient pas vérifiée, et un a même omis de dire qu’il n’avait rien pu lancer.
Ce n’est pas une question de compétence, c’est une question de discipline. Et sur la tâche où le modèle se trompe, c’est précisément cette différence qui décide si tu l’apprends tout de suite ou trois commits plus tard. Mon protocole était bancal, il m’a montré la chose la plus utile de la soirée.
Choisir son modèle : la ligne qu’il faut regarder
La doc d’Ollama pose une réserve d’une ligne, sans expliquer comment la vérifier : les outils fonctionnent « avec les modèles compatibles ». Traduction : si ton modèle ne sait pas appeler d’outils, Claude Code ne peut ni lire, ni écrire, ni lancer quoi que ce soit. Tu obtiens un agent qui te parle sans rien faire.
La commande qui te le dit avant de perdre une soirée :
ollama show qwen3.6:35bRegarde le bloc Capabilities. Il te faut tools dedans. S’il n’y est pas, change de modèle, inutile d’insister. Les deux autres réglages qui comptent :
- Le contexte. Ollama recommande au moins 32k, et 64k pour un vrai dépôt. Les instructions de Claude Code en mangent une bonne part avant même ta question.
- La taille du modèle ne fait pas la vitesse. Chez moi, le 12B a battu le 36B sur la tâche longue, et l’inverse sur la courte. Teste, ne déduis pas.
Honnêtement, je n’ai pas pu te montrer un cas d’échec : les sept modèles installés sur ma machine annoncent tous tools. Je ne peux donc pas te décrire ce que ça donne sans, je peux juste te dire où regarder.
Ce que ça vaut, et ce que ça ne vaut pas
Voilà où j’en suis après cette soirée, sans enthousiasme forcé ni condamnation.
- C’est gratuit et c’est illimité, ça au moins le tuto ne mentait pas. Aucun compteur, aucune fenêtre de cinq heures, ta machine et rien d’autre.
- C’est hors ligne, donc utilisable sur du code que tu ne veux envoyer à personne.
- C’est trois à dix fois plus lent, selon la longueur de la tâche.
- Ce n’est pas Claude. C’est l’outil Claude Code piloté par un autre modèle. Le nom sur la boîte ne change pas ce qu’il y a dedans.
- Ce n’est pas pris en charge par Anthropic, en toutes lettres dans leur doc.
La réserve d’usage, parce qu’elle est réelle : deux tâches, un essai chacune, une seule machine. Ce sont des mesures, pas un classement. Et mes deux tâches ont été réussies par tout le monde, donc ce banc ne dit rien de la tâche où le modèle local se plante. Il faudrait la chercher exprès, et ce sera pour un autre soir.
Les autres voies gratuites, dont une donne du vrai Claude
Avant de monter tout ça, la question de départ mérite une réponse nette : non, le plan gratuit d’Anthropic ne donne pas Claude Code. Il apparaît pour la première fois dans le plan Pro, à 17 dollars par mois avec engagement annuel, 20 au mois.
La confusion vient de la carte du plan gratuit elle-même, qui annonce « créer des fichiers et exécuter du code ». C’est vrai, et ça parle du chat, pas de l’agent. Le détail est dans la fiche complète de Claude Code.
Ce qui existe vraiment, en dehors du modèle local :
- Le programme Claude for Open Source. Six mois de Claude Max offerts aux mainteneurs et contributeurs open source qui remplissent l’un des critères publiés : 500 dépôts dépendants, ou 100 paquets dépendants, ou 200 000 téléchargements mensuels, ou être committer d’un projet de fondation, ou 100 pull requests fusionnées en douze mois dans des dépôts qu’on ne possède pas. C’est la seule voie qui donne les vrais modèles Claude sans payer.
- Les crédits offerts à l’ouverture d’un compte développeur. Anthropic parle d’« un petit montant de crédits gratuits » sans publier de chiffre. Tu verras passer « environ 5 dollars » sur plusieurs sites : ce montant n’est écrit sur aucune page officielle, je ne le reprends pas.
- Un autre serveur local que Ollama. LM Studio et llama.cpp exposent le même genre d’entrée compatible, le principe des trois variables ne change pas.
Le piège qui peut casser ta vraie session
Le seul vrai danger de cette manipulation n’est pas le modèle local, c’est l’endroit où tu poses les variables.
Si ANTHROPIC_BASE_URL atterrit dans tes variables d’environnement permanentes, ou dans le bloc env d’un fichier de réglages de Claude Code, toutes tes sessions partent vers ton modèle local. Y compris celles où tu croyais utiliser ton abonnement. Sans erreur, sans avertissement autre que le message sur les connecteurs, que tu auras appris à ignorer.
- Pose les variables dans le terminal, pour la session en cours, jamais en permanent.
- Ferme le terminal quand tu as fini, ça suffit à tout remettre en place.
- En cas de doute,
/statuset la ligneAnthropic base URLtranchent en une seconde.
Si tu n’as pas encore Claude Code sur ta machine, l’installation est détaillée dans le tuto d’installation sous Windows. Pour la partie Ollama, j’ai déjà écrit comment le mettre en place sans terminal, et si tu veux voir un modèle local piloter autre chose qu’un agent de code, il y a le workflow n8n branché sur Ollama.
Questions fréquentes
Claude Code est-il vraiment gratuit avec Ollama ?
Oui, au sens où tu ne paies rien et que rien n’est compté. Mais tu n’utilises pas les modèles Claude : tu utilises l’outil Claude Code, piloté par un modèle open source qui tourne sur ta machine. La qualité et la vitesse sont celles de ce modèle, pas celles de Claude.
Faut-il un proxy ou un programme intermédiaire ?
Non, plus depuis janvier 2026. Ollama parle nativement le format d’API que Claude Code utilise à partir de sa version 0.14.0. Les tutos qui installent un proxy, un serveur Flask ou une couche de traduction décrivent la situation d’avant.
Quelle configuration matérielle faut-il ?
De quoi faire tourner le modèle choisi, ce qui se joue surtout sur la mémoire vidéo. Un modèle de 12 milliards de paramètres quantifié tient dans une carte grand public récente, un modèle de 36 milliards demande nettement plus. Commence petit, mesure, puis monte.
Est-ce que ça consomme mon abonnement Claude ?
Non. Dès qu’une clé de passerelle est active, elle remplace la connexion claude.ai pour la session, et rien n’est décompté. C’est aussi la raison du message sur les connecteurs désactivés que tu verras au démarrage.
Anthropic interdit-il cette configuration ?
Non, mais ils ne la prennent pas en charge, et ils l’écrivent : ils ne soutiennent pas le routage de Claude Code vers des modèles non-Claude, quelle que soit la passerelle. La variable utilisée est officielle et documentée, l’usage qu’on en fait ici sort du périmètre prévu.
Quel modèle local choisir pour commencer ?
N’importe lequel dont ollama show affiche tools dans ses capacités, avec un contexte poussé à 32 000 tokens au minimum. Sans appel d’outils, Claude Code ne peut ni lire ni écrire de fichier, et l’agent devient un chat. C’est le seul critère éliminatoire.
Les sources de cet article
Les chronos et les commandes de cette page viennent de ma machine, le 22 août 2026, et le protocole est reproductible. Les faits sur les produits viennent des pages officielles des éditeurs, jamais d’un comparateur.
- L’annonce d’Ollama sur la compatibilité avec l’API Messages, 16 janvier 2026.
- Sa documentation d’intégration, pour les variables et le contexte.
- La page d’Anthropic sur les passerelles, d’où vient la phrase sur le non-support.
- La grille tarifaire et la page du programme open source.
- Le tuto dont il est question au début, publié le 17 juin 2026.