Un token, c’est quoi ? La réponse en une phrase
Un token, c’est le petit morceau de texte qu’une intelligence artificielle compte pour lire ce que tu écris et fabriquer sa réponse : le plus souvent un bout de mot, parfois un mot entier, une syllabe ou même un signe de ponctuation.
Autrement dit, l’IA ne lit pas des mots comme toi. Elle découpe ton texte en tokens, et c’est sur ces morceaux qu’elle travaille. Le mot « anticonstitutionnellement » pèse plusieurs tokens ; « chat » n’en pèse qu’un. Ça paraît anecdotique. Ça ne l’est pas, et on va voir pourquoi.
Pourquoi les IA comptent en tokens, pas en mots
Découper en mots semblerait plus simple. Sauf qu’un mot n’a rien d’universel : les langues n’ont pas les mêmes, certaines n’utilisent pas d’espaces, et un modèle doit aussi encaisser du code, des chiffres, de la ponctuation. Le token est un compromis : une unité assez petite pour tout représenter, assez stable pour rester efficace.
C’est le modèle qui fixe ce découpage, une fois pour toutes, à sa création. Toi tu écris des phrases ; lui voit une suite de tokens. Ce décalage explique deux ou trois bizarreries, dont la fameuse difficulté des IA à compter les lettres d’un mot. Elles ne voient pas les lettres. Elles voient des tokens.
Combien de tokens dans un texte ?
Un ordre de grandeur, donné par OpenAI elle-même : en anglais, un token vaut environ quatre caractères, et cent tokens font à peu près soixante-quinze mots (page d’aide officielle d’OpenAI sur les tokens). Un paragraphe courant tourne autour de cent tokens.
Une réserve, et elle compte : ces repères valent pour l’anglais. En français, le même texte pèse un peu plus : nos accents, nos terminaisons et nos mots plus longs se découpent en davantage de morceaux. Donc pour un compte exact, ne te fie pas à une règle mentale : les fournisseurs proposent des outils qui comptent les tokens réels d’un texte. Pour une estimation rapide, la règle des quatre caractères suffit.
Pourquoi ça te concerne : prix et limites
Deux raisons très concrètes, et c’est là que le mot cesse d’être un détail technique.
D’abord le prix. Quand tu utilises une IA via son API (la porte d’entrée pour les développeurs et les outils automatisés), tu paies au token, en entrée (ton prompt) comme en sortie (la réponse). Un prompt deux fois plus long coûte, en gros, deux fois plus cher. Ceux qui construisent des outils par-dessus ces modèles surveillent ce compteur de près.
Ensuite la limite. Chaque modèle a un plafond de tokens qu’il traite d’un coup, ce qu’on appelle sa fenêtre de contexte. Au-delà, il faut couper. C’est pour ça qu’une IA « oublie » parfois le début d’une très longue conversation : ce n’est pas de la distraction, c’est une limite de tokens.
Token, prompt, LLM : la chaîne complète
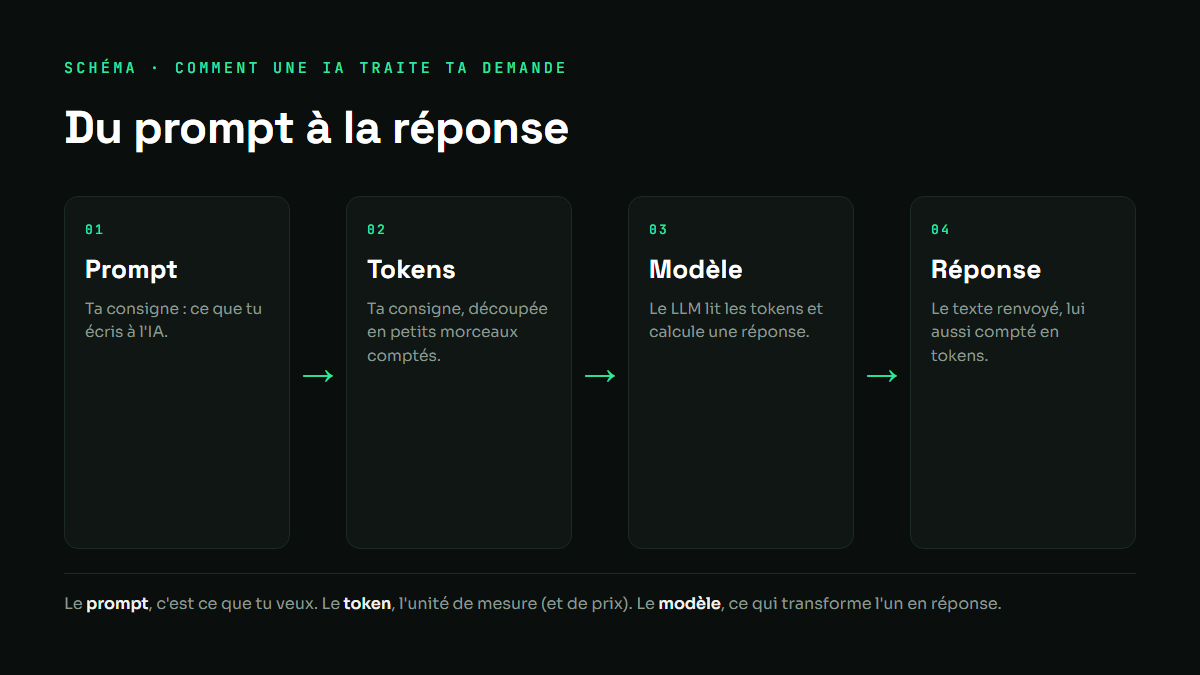
Le token ne vit jamais seul. Il est le maillon du milieu, entre ce que tu écris et le moteur qui répond. Remets les trois dans l’ordre : tu rédiges une consigne, le prompt ; cette consigne se découpe en tokens ; le grand modèle de langage lit ces tokens et produit sa réponse, elle aussi comptée en tokens.
Trois notions, une seule mécanique. Le prompt, c’est ce que tu veux. Le token, c’est l’unité de mesure. Le modèle, c’est ce qui transforme l’un en réponse. Comprends le token, et la facture comme les limites d’une IA cessent d’être un mystère.